

Pruebas de texto publicitario: flujo práctico antes del lanzamiento
Domina las pruebas de texto publicitario con esta guía práctica previa al lanzamiento. Valida mensajes, maximiza su impacto y consigue resultados.
Las pruebas de texto publicitario validan mensajes y creatividades con públicos representativos mediante métodos cuantitativos y cualitativos antes del lanzamiento, sin comprometer todavía presupuesto de medios. El mejor primer paso es elegir un KPI principal, crear tres variantes centradas en hipótesis diferentes y ejecutar un piloto pequeño con una regla clara de muestra antes de ampliar nada.
Este es el plan inmediato:
- Elige primero el KPI principal. CTR para campañas de conocimiento y CVR para campañas de resultados. Una métrica gobierna la decisión.
- Crea tres variantes con hipótesis distintas. No tres versiones del mismo titular, sino tres enfoques diferentes: beneficio, prueba y urgencia.
- Fija una regla de muestra antes de empezar. Decide el mínimo de impresiones o respuestas para obtener una señal orientativa y respétalo. No pares antes porque una variante parezca buena el segundo día.
Para conseguir señales más rápidas y económicas antes del gasto real, una plataforma de pruebas previas como Popjam combina simulación de públicos sintéticos con comentarios cuantitativos tempranos y evita llegar a ciegas al lanzamiento.
Conclusiones clave
Probar el texto antes de lanzar es una de las acciones de mayor impacto para reducir gasto desperdiciado y acelerar el aprendizaje creativo antes de activar la campaña.
| Punto | Detalles |
|---|---|
| Define primero el KPI principal | Elige una métrica, CTR para conocimiento o CVR para resultados, antes de diseñar variantes. |
| Crea una cartera con tres funciones | Usa Index, estable y escalable; Alpha, de alto potencial; y Hedge, centrada en pruebas, para distintos escenarios. |
| Fija la muestra antes de lanzar | Define el tamaño según presupuesto y objetivos para obtener una señal orientativa. |
| Valida ganadores en dos contextos | Una variante que solo gana en una ubicación depende del contexto y no es universalmente escalable. |
| Usa una rúbrica como filtro previo | Puntúa gancho, claridad, CTA y encaje de público antes de gastar en variantes débiles. |
| POPJAM para validar antes del lanzamiento | POPJAM.IO combina generación de anuncios con IA, simulación de personas sintéticas y rúbricas para validar antes del gasto de medios. |
Índice
- Qué son las pruebas de texto publicitario y cuándo hacerlas
- Qué métodos de prueba están disponibles
- Qué componentes del texto conviene probar
- Cómo diseñar, ejecutar y decidir una prueba de texto
- Qué KPI medir y cómo interpretarlos
- Qué herramientas permiten probar texto antes del lanzamiento
- Cómo convertir resultados en mejor texto
- Errores comunes que invalidan las pruebas
- Cómo las rúbricas de expertos con IA y las personas sintéticas mejoran la evaluación previa
- Ética y privacidad en las pruebas de texto publicitario
- Por qué «encontrar un ganador» es el enfoque equivocado
- POPJAM.IO reduce el coste de aprender antes de gastar
- Fuentes
- Preguntas frecuentes
Qué son las pruebas de texto publicitario y cuándo hacerlas
Las pruebas de texto, también llamadas copy testing o evaluación creativa publicitaria en investigación, exponen borradores de mensajes a un público representativo antes de comprometer una compra completa de medios. Se diferencian del A/B en mercado, donde se usa presupuesto real para encontrar un ganador. Las pruebas previas son más baratas y rápidas y permiten descartar variantes débiles antes de que cuesten dinero.
El A/B en mercado sigue siendo valioso, pero es otra herramienta. Se usa con tráfico suficiente para alcanzar significación pronto, variantes ya validadas de forma básica y un coste asumible de la perdedora. Cuando no se cumplen esas condiciones, conviene probar antes de lanzar.
Haz pruebas previas cuando:
- Lances una oferta nueva sin datos creativos históricos
- Entres en un segmento desconocido con otra psicografía
- Compres ubicaciones caras, como CTV o display premium, donde una creatividad débil resulta costosa
- Cambies posicionamiento o tono y necesites saber si la nueva voz conecta
- Cambies por completo el formato, por ejemplo de estático a vídeo o de texto largo a corto
Un equipo que lanza un SaaS en un nuevo sector puede probar tres enfoques de titular en una encuesta antes de invertir en Google Ads. La encuesta cuesta una fracción de una semana de medios y muestra qué enfoque conecta, confunde o se ignora. Ese tipo de información previa al lanzamiento reduce el aprendizaje de semanas a días.
Qué métodos de prueba están disponibles
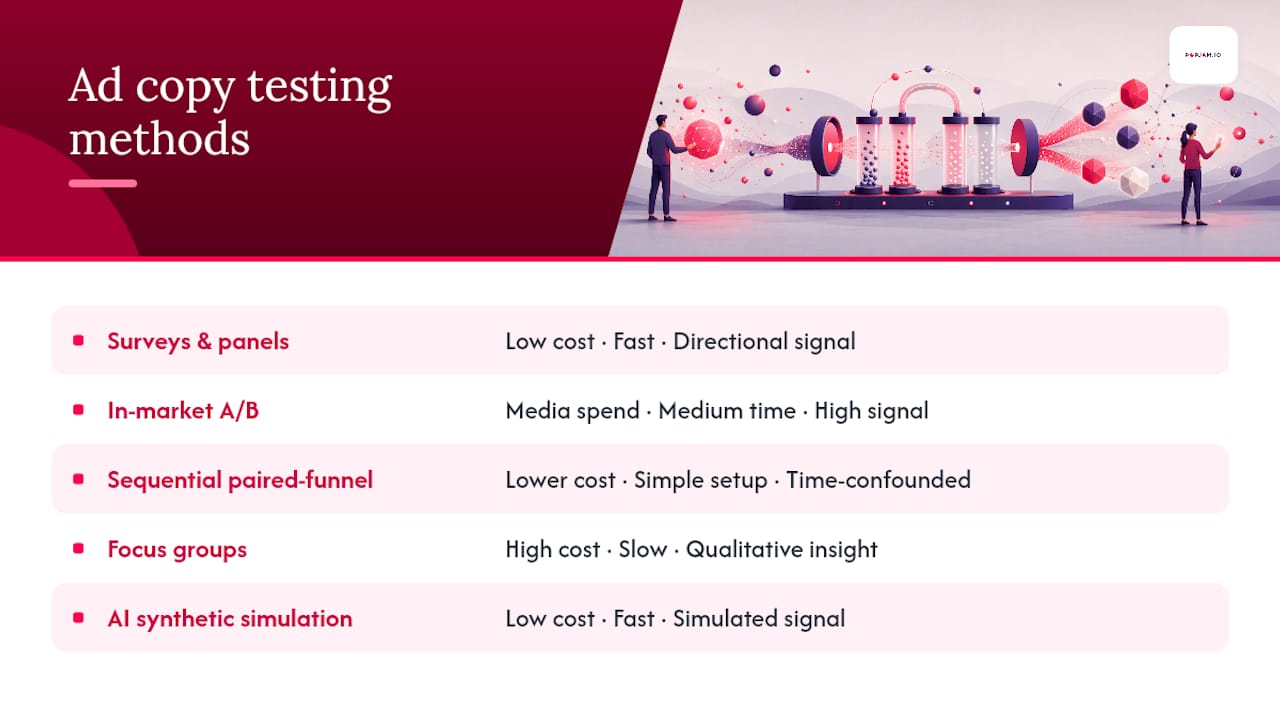
Las guías del sector identifican cinco métodos básicos: encuestas y paneles, A/B y multivariante en mercado, grupos de discusión, laboratorio con seguimiento ocular y biometría y simulación de públicos sintéticos con IA. Cada uno encaja en un presupuesto, plazo y necesidad de señal.
Encuestas y paneles
Un cuestionario estructurado presenta dos o más variantes y recoge preferencia, comprensión y respuestas abiertas. Es rápido, escalable y económico. Su límite es que la preferencia declarada no siempre predice conducta: conviene usarlo como filtro orientativo, no como veredicto final.
A/B y multivariante en mercado
Las variantes se ejecutan simultáneamente en un entorno real y se miden clics, conversiones y tiempo en página. La señal es de calidad porque refleja decisiones reales. Requiere gasto de medios y tráfico suficiente para significación. El multivariante es potente, pero necesita muestras mucho mayores para aislar efectos de variables individuales.
Pruebas secuenciales de embudos emparejados
Ejecuta A durante un periodo definido y luego B y compara. Es más sencillo que un A/B simultáneo, pero vulnerable a estacionalidad, noticias y otros factores temporales. Úsalo solo si la prueba simultánea no es posible.
Grupos de discusión
Pequeños grupos del público comentan la creatividad en una sesión moderada. Son excelentes para descubrir el porqué de las reacciones, especialmente con mensajes sensibles para la marca o emocionalmente complejos. Son caros y lentos, y la dinámica de grupo puede reprimir respuestas individuales sinceras.
Seguimiento ocular y laboratorios biométricos
El seguimiento ocular muestra dónde se dirige la atención en imágenes o vídeo. La respuesta galvánica de la piel y la codificación facial miden activación y valencia emocional. Aportan datos psicofisiológicos ricos, pero requieren equipamiento y participantes especializados y son la opción más cara. Resérvalos para campañas de gran importancia o decisiones de plataforma de marca.
Pruebas de usabilidad
Los participantes interactúan con un anuncio o destino mientras narran su experiencia. Sirven para detectar textos técnicamente claros pero confusos en la práctica y el contexto.
Simulación de públicos sintéticos con IA
Los modelos simulan cómo reaccionarían personas definidas y puntúan fuerza del gancho, claridad y resonancia emocional, como explican artículos prácticos sobre IA en diseño. Es rápido, barato y compatible con la privacidad del RGPD al no usar encuestados reales. La contrapartida es que los modelos de visión y lenguaje muestran diferencias medibles respecto al juicio humano. Sus puntuaciones deben complementar la revisión humana, no sustituirla por completo.
Lo mejor es un enfoque híbrido. Usa simulación para ordenar y filtrar, lleva las dos mejores a un panel para profundizar y valida la ganadora en un piloto pequeño en vivo. Cada capa añade información sin asumir desde el inicio todo el coste de medios.
Qué componentes del texto conviene probar
Muchos equipos prueban el titular y se detienen. Así pierden aprendizaje. Los elementos que más influyen están repartidos por toda la creatividad y probarlos aislados produce conclusiones frágiles.
Elementos que merece la pena aislar:
- Titular o gancho: La primera línea o los primeros tres segundos. ¿Detienen el desplazamiento?
- Enfoque de la propuesta de valor: ¿Empieza por el resultado, la función o el alivio de un problema?
- Beneficio principal: ¿Cuál destaca: rapidez, ahorro, estatus o seguridad?
- Tipo de prueba: ¿Prueba social con reseñas y usuarios, autoridad con certificaciones y prensa o concreción con cifras y casos?
- Redacción de CTA: «Empieza la prueba gratis», «Obtén tu informe gratuito» y «Mira cómo funciona» señalan distintos compromisos.
- Tono y voz: Conversacional, experto o juguetón. ¿Encaja con la autoimagen del público?
- Longitud: Texto corto y directo o explicación extensa. Depende mucho de ubicación y fase del embudo.
- Texto en pantalla frente a pie de publicación: En vídeo y redes, la posición cambia cómo se procesa el mensaje.
- Combinación visual: Un mismo titular funciona distinto junto a producto, estilo de vida o visualización de datos.
La investigación sobre novedad y utilidad muestra que ambas dimensiones juntas determinan la eficacia. Un anuncio novedoso que capta atención pero no aclara su valor suele fallar al convertir. La implicación es directa: combina variantes llamativas con controles de claridad.
Una matriz sencilla sería:
| Enfoque del titular | CTA | Estilo de imagen |
|---|---|---|
| Beneficio: «Reduce a la mitad tu gasto publicitario» | «Empieza gratis» | Captura del producto |
| Prueba: «Muchos equipos confían en nosotros» | «Ver resultados» | Collage de prueba social |
| Urgencia: «La oferta termina el viernes» | «Reserva tu plaza» | Cuenta atrás o imagen de escasez |
Tres titulares, dos CTA y dos estilos visuales producen doce combinaciones en un factorial completo. Son demasiadas para ejecutar a la vez con poco presupuesto. Elige la dimensión más incierta, fija las otras y prueba un eje cada vez. Trata el texto como sistema entre ubicaciones y fases, no como frases aisladas. Un titular ganador en Meta puede rendir mal en LinkedIn porque el contexto cambia.
Cómo diseñar, ejecutar y decidir una prueba de texto
Esta es la parte operativa. Sigue los pasos en orden para evitar los errores más comunes.
-
Escribe el brief. Indica objetivo, KPI principal, hipótesis concreta, por ejemplo «Creemos que un titular de beneficio superará a uno de prueba para públicos fríos», segmento y umbral de éxito, como «B gana si aumenta el CTR al menos un 15 % con un 95 % de confianza».
-
Diseña la cartera de variantes. Piensa en tres funciones: Index, el texto actual más eficaz o conservador que se puede ampliar; Alpha, el enfoque novedoso de alto potencial; y Hedge, texto con abundantes pruebas y confianza. Cada uno tiene una tarea. Este enfoque de cartera trata la prueba como estrategia de variación, no como concurso de belleza.
-
Bloquea las variables no probadas. Mismo público, puja, ubicación y dimensiones. Solo cambia el elemento textual bajo prueba. Cambiar la segmentación a mitad invalida el experimento.
-
Elige ubicaciones y contextos de validación. Ganar en un contexto no garantiza ganar en todos. Valida la mejor variante en al menos dos ubicaciones o segmentos antes de ampliar.
-
Fija la muestra antes de empezar. La tabla siguiente ofrece reglas prácticas para tres escalas de prueba.
Un marco práctico recomienda cinco enfoques de titular con tres tipos de descripción, eliminación secuencial hasta un ganador y validación siempre con métricas de conversión posteriores, no solo CTR.
-
Ejecuta y supervisa sin tocar. No pauses antes las variantes débiles, ni cambies segmentación o pujas. Las ventanas de aprendizaje suelen necesitar 7–14 días para estabilizarse y los datos iniciales tienen ruido.
-
Aplica reglas de decisión. Busca un 95 % de confianza estadística. Con varias variantes simultáneas, aplica Bonferroni u otra corrección por comparaciones múltiples. Si dos quedan dentro del margen de error, suele ser práctico elegir la de mejores comentarios cualitativos.
-
Orientación de presupuesto. Un piloto pequeño puede usar 500–1.500 $ si el CPM es razonable. Uno medio suele necesitar 3.000–8.000 $. Los grandes con validación de conversión posterior pueden alcanzar 15.000 $ o más. POPJAM.IO puede reducirlo filtrando variantes débiles antes de cualquier gasto real.
Consejo práctico: Ejecuta la mejor variante en dos contextos de público a la vez. Si gana en ambos, es estable para ampliar. Si solo gana en uno, es una herramienta situacional, no una solución universal.
Qué KPI medir y cómo interpretarlos
La métrica principal depende del objetivo. Así se organiza por fase del embudo.
Atención, parte alta del embudo
- CTR, tasa de clics: Señal más común de eficacia del texto en conocimiento. Mide si titular y gancho convencen para hacer clic.
- Tasa de visualización o finalización: En vídeo, cuánto se ve antes de abandonar. Una gran caída en tres segundos suele señalar un gancho fallido.
- Tasa de detención del desplazamiento: Porcentaje de usuarios que se detiene en el anuncio social. Indicador temprano de fuerza del gancho.
Interacción en la parte media
- Tiempo con el recurso: Cuánto interactúan con formatos interactivos o rich media.
- Microconversiones: Registros por correo, descargas y cuestionarios completados. Útiles cuando la conversión final es demasiado escasa para significación rápida.
- Profundidad de desplazamiento del destino: En páginas largas indica si funciona la correspondencia entre mensaje del anuncio y página.
Parte baja del embudo
- Tasa de conversión, CVR: Porcentaje de clics que termina en la acción deseada. Es la métrica principal de campañas de resultados.
- Coste de adquisición, CPA: Gasto total dividido entre conversiones. Indica si el ganador en CTR es realmente eficiente.
- Retorno del gasto publicitario, ROAS: Ingresos por dólar gastado. Métrica final de rendimiento para comercio electrónico.
Métricas de marca
- Recuerdo publicitario: Medido con encuestas de brand lift. ¿Recuerda el público haber visto el anuncio?
- Favorabilidad de marca: ¿Mejoró la percepción tras la exposición?
- Resonancia emocional: Medida cualitativa o biométrica de lo que hizo sentir el anuncio.
Interpretar señales contradictorias es donde muchos equipos se atascan. Más CTR y menos CVR suele significar público equivocado o promesas excesivas. Menos CTR y más CVR suele indicar que el texto cualifica al público, a menudo mejor para resultados. Ante conflicto, manda la métrica posterior si el objetivo es rendimiento y la anterior si es conocimiento.
Calcula el incremento dividiendo la diferencia entre variante y control por el valor del control y multiplicando por 100. Esa cifra importa para decisiones de negocio, no la diferencia absoluta.
Qué herramientas permiten probar texto antes del lanzamiento
Las herramientas se agrupan en cinco categorías con resultados y usos distintos.
Paneles de encuesta como Attest, Pollfish y Wynter: muestran borradores a participantes filtrados y recogen preferencias cuantitativas y respuestas abiertas. Ideales para ordenar hipótesis y comprobar claridad.
Plataformas de laboratorio, proveedores de seguimiento ocular y biometría: generan mapas de atención, puntuaciones de activación emocional y fijaciones. Señal de alta calidad, alto coste y plazos largos.
Analítica creativa: analiza resultados reales e identifica patrones en el archivo de anuncios. Útil para aprender retrospectivamente, no para pruebas previas auténticas.
Simulación con IA: genera reacciones sintéticas mediante modelos de personas. Rápida, económica y respetuosa con la privacidad. Suele dar puntuaciones por dimensión y comentarios resumidos por IA. La diferencia frente al juicio humano la hace más adecuada como filtro y priorización que como motor de decisión final.
Pilotos conductuales ligeros: pruebas pequeñas en ubicaciones baratas, como Facebook Audience Network o Google Display, con presupuestos limitados. Datos reales por una fracción del coste de una campaña completa.
Qué buscar en una plataforma:
- Simulación sintética con psicografía configurable
- Puntuación por personas en varias dimensiones creativas
- Informe cuantitativo y cualitativo en una sola exportación
- Resumen con IA de respuestas abiertas para no leer 500 individualmente
- Simulación consciente del RGPD sin datos de encuestados reales
- API para integrar las pruebas en la producción
POPJAM.IO cubre todo ello. Genera recursos de marca, los prueba con personas sintéticas antes de lanzar y presenta KPI junto a comentarios abiertos resumidos con IA. Los equipos de Meta, Google, TikTok, LinkedIn y Reddit pueden validar las cinco ubicaciones antes de gastar. Su guía comparativa permite profundizar en las diferencias entre herramientas creativas de IA del mercado.
Ejemplo de resultado:
Resumen de KPI: B obtiene 78/100 en gancho, 65/100 en claridad y 82/100 en CTA. A obtiene 61/100, 71/100 y 58/100 respectivamente.
Comentarios abiertos resumidos con IA: Los participantes describen la primera línea de B como «relevante de inmediato» y «específica para mi situación». La crítica más común a A es un beneficio genérico. Tres de cinco personas consideran que su CTA no aclara el siguiente paso.
Ese resultado dice al equipo exactamente qué corregir, no solo qué variante ganó.
Cómo convertir resultados en mejor texto
Puntuaciones y porcentajes no escriben anuncios mejores. Así se convierten en cambios concretos.
Cuando gana CTR pero no acompaña CVR: El gancho funciona, pero cuerpo o destino incumplen la promesa. Alinea el mensaje. Si el titular promete «Reduce tu gasto a la mitad», el titular del destino debe reflejar esa misma afirmación.
Cuando lo cualitativo contradice el incremento cuantitativo: Usa lo cualitativo para diagnosticar y lo cuantitativo para decidir. Si gana CTR pero las respuestas dicen «engañoso», se avecinan bajas y devoluciones. Corrige antes de ampliar.
Ejemplos de cambios pequeños:
- «Herramientas de IA para marketing» pasa a «Descubre qué anuncio gana antes de gastar»: de categoría a resultado concreto.
- Sustituir «miles confían en nosotros» por «4,8 estrellas en 1.200 reseñas» añade precisión que suele elevar CVR.
- Mover la CTA del pie de publicación al texto en pantalla suele aumentar la intención de clic de quienes ven sin sonido, una gran parte del consumo social.
Clasificación de resultados y próximos pasos:
- Escalable estable: Gana en varios contextos. Amplíala y añádela como control de referencia.
- Ganadora dependiente del contexto: Gana en una ubicación o público, no en otros. Úsala cuando encaje. No la retires ni la trates como universal.
- Alto potencial pero volátil: Fuerte en unas pruebas y débil en otras. Consérvala como Alpha y vigílala.
- Perdedora: Rinde mal de forma consistente. Documenta qué falló y por qué y retírala. El archivo de perdedoras vale tanto como el de ganadoras.
Errores comunes que invalidan las pruebas
La mayoría de los fallos son operativos. Estas son las trampas y cómo evitarlas.
-
Probar varias variables sin muestra suficiente. Cambiar titular, CTA e imagen a la vez impide atribuir el efecto. Cambia una variable principal o usa diseño factorial completo con muestra suficiente.
-
Pruebas sin potencia suficiente. Parar tras 500 impresiones porque una parece mejor es una receta para equivocarse. Fija la muestra mínima antes y no toques la prueba hasta alcanzarla.
-
Sesgo de combinación de plataforma. Google y Meta recombinan titulares y descripciones de forma dinámica y optimizan sobre tu experimento. Fija recursos críticos o usa anuncios separados para que el sesgo de selección no contamine los resultados.
-
No validar ganadores entre contextos. Una ganadora en retargeting suele fallar en prospección fría. Valídala en al menos dos contextos antes de considerarla universal.
-
Ignorar señales cualitativas. Ganar CTR con comentarios confusos o negativos es una victoria corta con riesgo largo. Lee las respuestas abiertas. La IA permite resumirlas rápido incluso a escala.
-
Sobreajustar a picos breves. Un pico de la primera semana suele regresar cuando el público se fatiga. Prueba hasta ver estabilizarse la tendencia, no solo el pico inicial.
Ejemplo real: Un equipo cambió en el cuarto día su segmentación de Google Ads de concordancia amplia a exacta por un CTR inicial bajo. Las dos mitades acabaron con públicos distintos y la comparación perdió sentido. La solución es fijar al inicio toda variable no probada y mantenerla hasta el final.
Cómo las rúbricas de expertos con IA y las personas sintéticas mejoran la evaluación previa
El método previo más reproducible combina una rúbrica estructurada con simulación por personas. Un enfoque de panel experto de IA de código abierto usa tres personas y ocho dimensiones, da mayor peso a gancho y CTA y analiza desacuerdos para proponer mejoras concretas.
Las ocho dimensiones:
| Dimensión | Qué puntuar | Por qué importa |
|---|---|---|
| Gancho | ¿La primera línea o imagen detiene el desplazamiento? | La primera impresión determina si se verá el resto |
| Claridad del mensaje | ¿Se entiende de inmediato la oferta principal? | Un público confundido no hace clic |
| Alineación visual | ¿La imagen refuerza o contradice el texto? | La discordancia reduce el recuerdo del mensaje |
| Encaje con el público | ¿Tono y lenguaje coinciden con la autoimagen de la persona? | Un registro inadecuado indica que el anuncio no es para ella |
| Ritmo | ¿La densidad informativa del vídeo o animación encaja con la atención? | Demasiado rápido perjudica comprensión; demasiado lento pierde atención |
| Eficacia de CTA | ¿El siguiente paso es claro y sencillo? | CTA débiles son la causa más común de alto CTR y bajo CVR |
| Resonancia emocional | ¿Provoca la emoción prevista? | La emoción impulsa recuerdo y difusión |
| Eficacia sin sonido | ¿Comunica el mensaje sin audio? | Gran parte del vídeo social se ve silenciado |
Antes de una prueba formal, una rúbrica como MOCA, Magnetic, Obvious, Congruent, Actionable, filtra recursos débiles antes de gastar. Una creatividad por debajo del umbral en Magnetic, si capta atención, u Obvious, si la oferta es clara, no debe entrar en una prueba en vivo. Corrígela primero.
Para vídeo y animación, el análisis de fotogramas examina el gancho, normalmente fotogramas 1–3, y la CTA para comprobar que comuniquen por separado. Un gancho que necesita audio rendirá peor en entornos silenciados.
Flujo de mejora cuando las puntuaciones son bajas:
- Gancho bajo: genera nuevas aperturas con resultado más específico o interrupción de patrón más fuerte.
- Claridad baja: reduce la propuesta de valor a una frase y elimina lo que no respalde el beneficio principal.
- CTA baja: prueba un siguiente paso concreto, «Descarga el informe de referencias de 2026», frente a «Más información».
- Encaje bajo: ajusta tono, vocabulario y referencias al lenguaje de la persona y vuelve a simular antes de probar en vivo.
Ética y privacidad en las pruebas de texto publicitario
Estas pruebas involucran atención, datos y a veces información personal real. Eso crea responsabilidades que van más allá de marcar casillas de cumplimiento.
Consentimiento informado en paneles. Los participantes de encuestas o grupos deben saber que evalúan publicidad. Ocultar el fin comercial vulnera directrices éticas habituales y erosiona la confianza en la investigación de mercados.
Minimización de datos en pilotos conductuales. Los pilotos recogen conducta real. Recopila solo lo necesario para la pregunta de prueba. No los uses para crear perfiles más allá de su alcance.
Personas sintéticas y RGPD. La simulación con personas sintéticas en lugar de encuestados evita muchos problemas de consentimiento y privacidad. POPJAM.IO incorpora el RGPD desde el diseño porque no procesa datos personales reales para generar reacciones. Es una ventaja para mercados regulados o categorías sensibles.
Sesgo en los modelos de puntuación. Entrenar rúbricas con resultados históricos puede incorporar sesgos: favorecer estilos que funcionaron en grupos dominantes y puntuar peor creatividades para públicos infrarrepresentados. Audita los resultados por segmento y añade revisión humana en campañas para públicos diversos o minoritarios.
Transparencia con el público. Optimizar la persuasión implica responsabilidad de exactitud. Un texto que conecta emocionalmente pero exagera afirmaciones del producto es un problema ético y un riesgo legal según las directrices de la FTC sobre fundamentación publicitaria.
Por qué «encontrar un ganador» es el enfoque equivocado
La mayoría busca un único ganador que ampliar. Ese modelo explica por qué muchos anuncios «ganadores» se estancan después de dos semanas.
Es más útil pensar en una estrategia de variación. Construyes una cartera que funciona de forma fiable en varios contextos, con funciones distintas. Una variante estable atiende al público principal. Alpha explora territorio nuevo. Hedge protege cuando la escalable se fatiga.
Mi experiencia con pruebas en varios contextos es que el filtro previo crea gran parte del valor. Saltárselo desperdicia una porción desproporcionada del presupuesto en variantes que cinco minutos de revisión habrían eliminado. MOCA permite revisarlas rápida y repetiblemente. Puntúa Magnetic, Obvious, Congruent y Actionable antes de probar. Si falla en dos dimensiones o más, se reescribe, no se prueba.
Dos prácticas acumulan valor: mantener una campaña de control siempre activa para nuevas comparaciones y un archivo de patrones ganadores ordenado por segmento y fase. Ese archivo transforma pruebas aisladas en conocimiento de la organización. Sin él, cada campaña vuelve a empezar de cero.
POPJAM.IO reduce el coste de aprender antes de gastar
El gasto desperdiciado suele venir de lanzar material sin validar. POPJAM.IO cubre esa carencia: genera creatividades de marca y las prueba con personas sintéticas antes de comprometer presupuesto. Proporciona puntuaciones y comentarios cualitativos resumidos por IA para decidir con confianza.
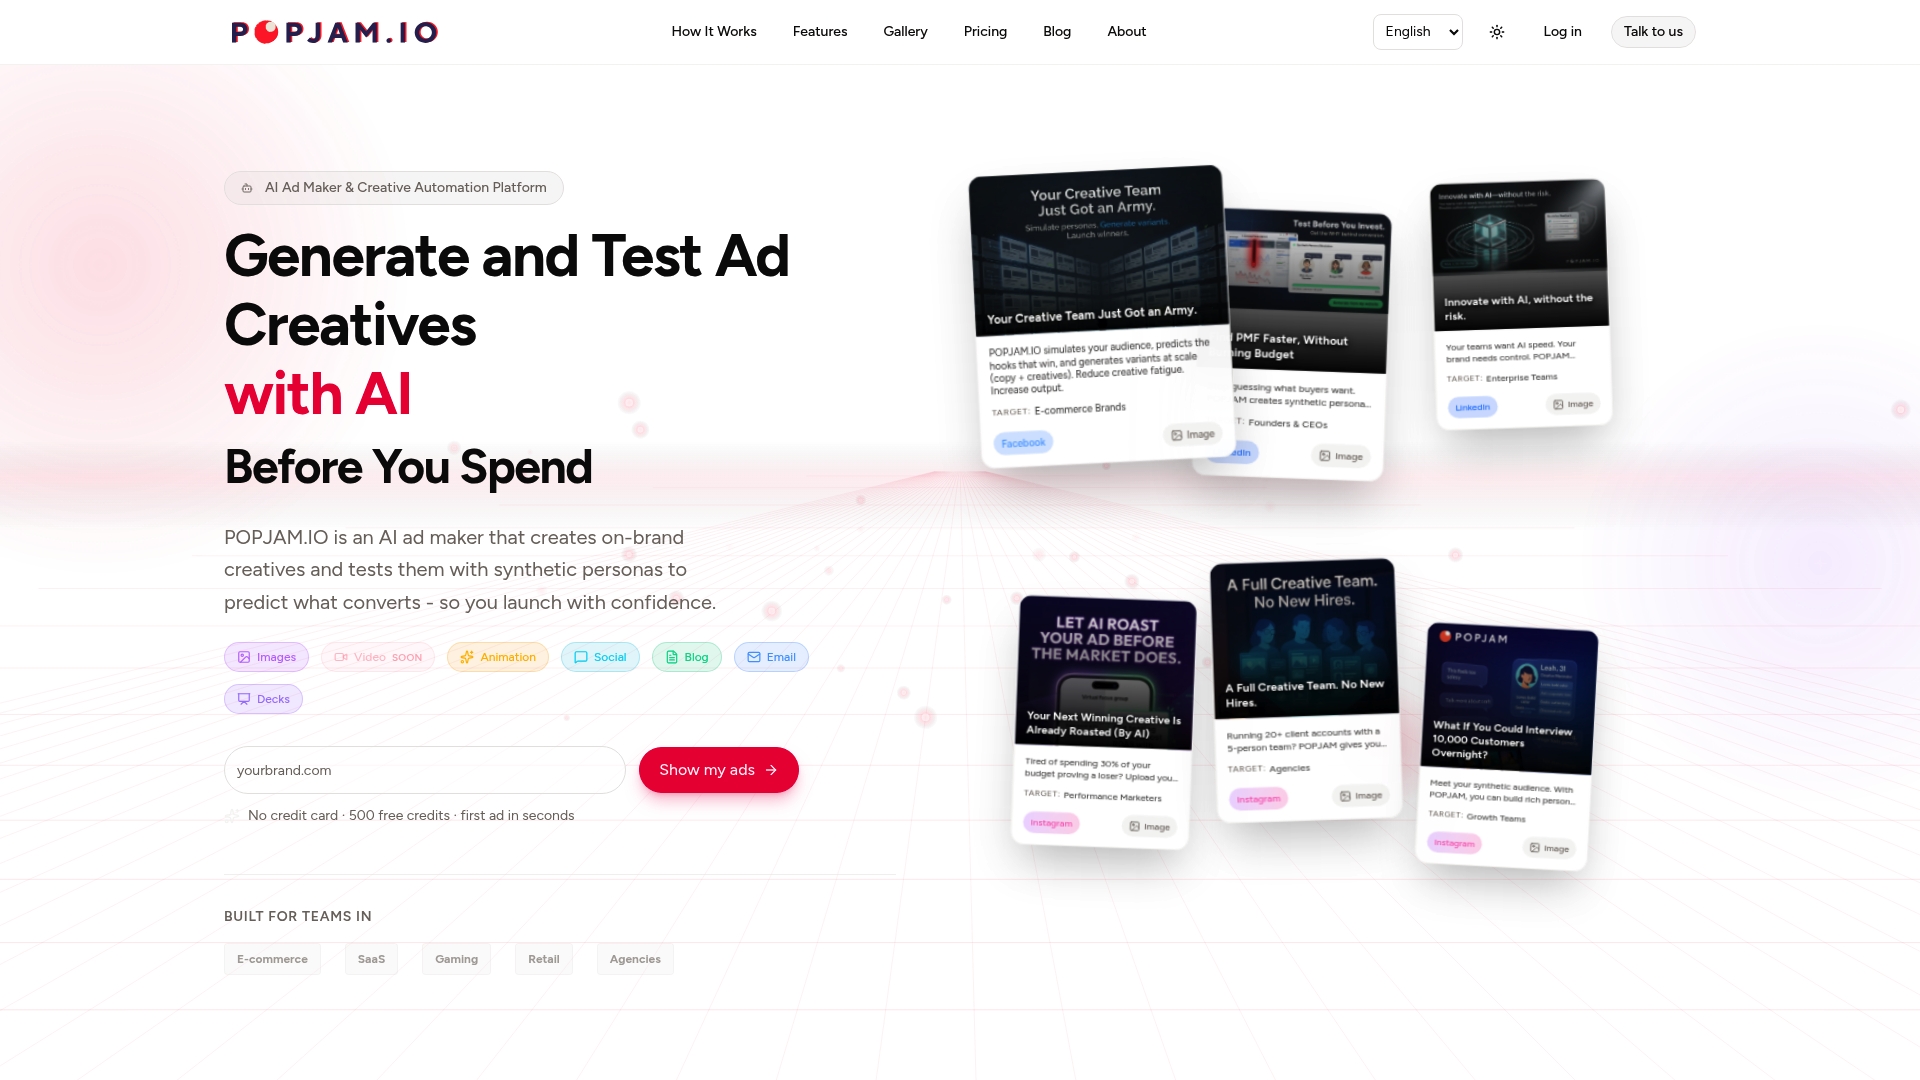
El flujo es directo. Generas variantes, las simulas en los segmentos objetivo y recibes KPI, rúbricas y respuestas abiertas en un informe exportable. Sin reclutar paneles, esperar semanas de laboratorio ni adivinar el titular adecuado. Equipos de comercio electrónico, SaaS y agencias validan Meta, Google, TikTok, LinkedIn y Reddit antes de pagar ubicaciones. El resultado es menos impresiones desperdiciadas, iteraciones más rápidas y creatividades ya validadas con perfiles psicográficos reales. Inicia tu prueba gratis en Popjam y ejecuta hoy tu primera prueba previa al lanzamiento.
Fuentes
- Investigación sobre novedad y utilidad en evaluación creativa, Nature
- Uso de grandes modelos para evaluar contenido novedoso: un caso práctico
- 5 métodos de prueba de texto publicitario y por qué funcionan
Preguntas frecuentes
¿Qué son las pruebas de texto publicitario?
Validan mensajes y creatividades con un público representativo antes del lanzamiento mediante métricas cuantitativas y comentarios cualitativos para identificar las variantes con mayor probabilidad de funcionar.
¿Cuál sería un ejemplo en publicidad?
Un equipo que lanza un SaaS prueba tres titulares en un panel antes de comprar Google Ads. Los participantes puntúan claridad y atractivo y sus respuestas abiertas revelan qué enfoque del beneficio conecta más con el segmento.
¿Qué es una prueba B de texto publicitario?
Una prueba B, o A/B, compara dos mensajes, normalmente control A y alternativa B, para medir cuál mejora un KPI definido como CTR o CVR. Gana la variante con mejora estadísticamente significativa.
¿Cuál es la finalidad del texto publicitario?
Comunicar un mensaje concreto a un público definido para lograr una acción medible, como clic, registro o compra. El texto eficaz equilibra novedad que llama la atención con información clara y útil sobre la oferta.
¿Cómo encaja POPJAM.IO en un flujo de pruebas previas?
Genera variantes y las prueba con personas sintéticas antes del gasto de medios. Produce puntuaciones de rúbrica y comentarios resumidos por IA para seleccionar y perfeccionar las mejores antes de lanzar.
Recomendado
- Cómo probar creatividades antes de lanzar | POPJAM | Blog de POPJAM.IO
- Pruebas creativas previas: manual de 2026 para equipos pequeños | POPJAM | Blog de POPJAM.IO
- Cómo probar creatividades antes del lanzamiento, guía 2026 | Blog de POPJAM.IO
- POPJAM: el creador de anuncios con IA que prueba antes de gastar