Datos sintéticos en marketing: la guía práctica para 2026
Aprende a usar datos sintéticos en marketing para probar creativos y simular audiencias con IA generativa; valida resultados antes de invertir.

Los datos sintéticos permiten probar creativos y simular audiencias rápidamente sin usar datos personales reales. Según MIT Sloan Management Review, la inteligencia artificial generativa puede comprimir plazos de investigación de meses a días cuando existe una infraestructura de calidad detrás. La promesa es real, pero exige validación constante: sin ella, los resultados pueden sonar convincentes y estar equivocados.
En resumen:
- La fiabilidad de los datos sintéticos aumenta si el proceso incluye validaciones con un R² superior a 0,7 en las preguntas de control.
- Los datos sintéticos son útiles para validar conceptos, acceder a segmentos difíciles y probar variantes creativas antes de invertir en campañas reales.
- Su principal beneficio es la velocidad, pues permiten simulaciones en horas que antes requerían semanas, aunque sobreestiman respuestas positivas y reducen varianzas individuales.
- La técnica de privacidad diferencial garantiza la protección contra la reidentificación, facilitando análisis sin comprometer datos reales de clientes.
- Un piloto correcto requiere definir claramente el objetivo, seleccionar el tipo de síntesis adecuado y validar los resultados con comparaciones entre simulaciones y datos reales.
Tabla de contenidos
- ¿Qué son los datos sintéticos y qué tipos existen?
- Cómo se generan: grounding, modelos y controles de calidad
- Casos de uso prácticos en marketing e investigación de audiencias
- Beneficios, límites y consideraciones de privacidad
- Cómo empezar: un plan de piloto paso a paso para equipos de marketing
- Perspectiva del autor: lecciones operativas desde POPJAM
- Opción práctica: generar y validar anuncios con audiencias sintéticas en POPJAM
- Preguntas frecuentes
- Fuentes
¿Qué son los datos sintéticos y qué tipos existen?
Los datos sintéticos son información generada por modelos de inteligencia artificial que imita patrones, comportamientos o respuestas humanas sin provenir de personas reales. En marketing, esto significa simular cómo reaccionaría una audiencia ante un anuncio, un mensaje o un producto antes de invertir presupuesto real en ello.
No todos los datos sintéticos sirven para lo mismo. Según la taxonomía propuesta en una investigación académica reciente, existen tres tipos principales de datos sintéticos aplicados a estudios de mercado:
- Respuestas no ancladas: generadas sin ningún dato real de referencia, útiles solo para explorar ideas iniciales.
- Personas de segmento: perfiles que representan a un grupo demográfico o psicográfico amplio, construidos a partir de patrones agregados.
- Gemelos digitales individuales: réplicas más específicas de un comprador concreto, ancladas en datos reales previos de esa persona o de personas similares.
Para un test rápido de concepto, una persona de segmento suele bastar. Para decisiones que dependen de matices individuales, como el comportamiento de un cliente de alto valor, un gemelo digital ofrece mayor precisión.
Cómo se generan: grounding, modelos y controles de calidad
Crear un conjunto de datos sintéticos fiable no es simplemente pedirle a un modelo de lenguaje que “invente” respuestas de consumidores. El proceso parte de datos reales (encuestas, transcripciones, historiales de compra) que alimentan modelos probabilísticos o arquitecturas generativas, y de ahí sale una simulación calibrada contra esa base.
El paso que marca la diferencia entre un dato útil y una alucinación costosa es el llamado grounding: anclar las respuestas generadas en información real mediante técnicas como la recuperación aumentada (RAG) y la calibración continua contra resultados conocidos.
Antes de confiar en un conjunto sintético para una decisión de campaña, conviene seguir una secuencia de verificación:
- Calcular el diagnóstico R² sobre una “pregunta olvidada” (forgotten question) para estimar si el modelo puede responder con fiabilidad algo que no vio directamente.
- Revisar la distribución de respuestas y compararla con patrones conocidos de la categoría o el segmento.
- Aplicar red-teaming: forzar al sistema con preguntas difíciles o sesgadas para detectar fallos sistemáticos.
- Monitorear el desempeño de forma continua, no solo en el momento de la generación inicial.
Consejo profesional: antes de escalar un piloto, exige siempre un R² por encima de 0,7 en las preguntas de control; por debajo de ese umbral, trata los resultados como orientativos, nunca como base de decisión.
Casos de uso prácticos en marketing e investigación de audiencias
Los equipos de marketing que ya trabajan con datos sintéticos los usan sobre todo en tres momentos del proceso creativo y de investigación.
- Validación de conceptos: probar mensajes, propuestas de valor o nombres de producto antes de invertir en producción final.
- Acceso a segmentos difíciles de reclutar: simular reacciones de públicos nicho (profesionales médicos, compradores de lujo, usuarios técnicos) cuando el reclutamiento real es lento o caro, para decidir qué pruebas con personas reales merecen la pena.
- Generación y comparación de variantes creativas: crear varias versiones de un anuncio y observar cuál genera mejor respuesta simulada antes de lanzar un test A/B real.
- Refinamiento de copy: ajustar tono, estructura y llamado a la acción con retroalimentación simulada previa al testeo con presupuesto real.
Ninguno de estos usos sustituye la validación final con clientes reales. Funcionan mejor como un filtro: reducen el número de ideas que llegan a la fase costosa de prueba, priorizando las que ya mostraron señales sólidas en la simulación.
Beneficios, límites y consideraciones de privacidad
La velocidad es el beneficio más citado: lo que antes tomaba semanas de reclutamiento y encuestas puede simularse en horas. También reduce el coste de llegar a segmentos pequeños o geográficamente dispersos, y permite iterar sobre una idea creativa varias veces antes de gastar en medios.
Pero los límites son reales y conviene tenerlos presentes:
- Los métodos sintéticos tienden a sobreestimar respuestas positivas frente a lo que ocurre con personas reales.
- Suelen reducir la varianza individual, lo que los hace menos confiables para decisiones que dependen de un comportamiento muy específico.
- Su fiabilidad cae en categorías poco representadas en los datos de entrenamiento originales.
En pruebas controladas, los datasets sintéticos llegaron a coincidir hasta en un 95 % con las conclusiones de estudios humanos tradicionales, lo que respalda su uso como herramienta de filtrado inicial, no como reemplazo definitivo de la investigación con personas reales.
En cuanto a privacidad, la técnica de privacidad diferencial permite generar datos sintéticos con garantías matemáticas contra la reidentificación, de forma que puedan analizarse con herramientas convencionales sin exponer información de clientes reales. El Instituto Nacional de Estándares y Tecnología de Estados Unidos (NIST) publica benchmarks y metodologías para medir ese riesgo, un marco de referencia útil al evaluar cualquier proveedor que trabaje con datos sintéticos.

Cómo empezar: un plan de piloto paso a paso para equipos de marketing
Lanzar un piloto bien diseñado evita dos errores comunes: descartar los datos sintéticos por un mal primer intento, o confiar en ellos más de lo que su fiabilidad real permite.
- Define el objetivo y la pregunta concreta: ¿quieres validar un concepto creativo, priorizar variantes de anuncio o explorar un segmento nuevo?
- Elige el tipo de síntesis adecuado: una persona de segmento para preguntas generales, un gemelo digital cuando necesitas precisión sobre un perfil específico.
- Selecciona los datos de anclaje: encuestas previas, historiales de campaña o investigaciones cualitativas que sirvan de base real al modelo.
- Diseña el experimento en paralelo: corre la simulación y, cuando sea posible, una muestra pequeña de validación con personas reales.
- Mide con los diagnósticos correctos: calcula el R² sobre preguntas de control, compara correlación de resultados agregados y revisa la concordancia en pruebas A/B simuladas frente a las reales.
- Decide el criterio de escalado: solo amplía el uso de datos sintéticos a decisiones de mayor presupuesto si los diagnósticos se mantienen estables en más de un ciclo de prueba.
Consejo profesional: corre siempre el piloto sobre una decisión de bajo riesgo primero: una variante de copy o un ángulo creativo, nunca el presupuesto completo de una campaña nueva.
Perspectiva del autor: lecciones operativas desde POPJAM
Hemos generado y probado anuncios con personas sintéticas, y la lección más clara es que la velocidad solo vale algo cuando va acompañada de criterio. Los equipos que mejores resultados obtienen no buscan una respuesta perfecta: usan la simulación para descartar lo débil y guardar el presupuesto real para lo que ya mostró señales sólidas. Esperar precisión absoluta en decisiones individuales es pedirle a esta tecnología algo que, hoy, no puede garantizar.
— Doruk
Opción práctica: generar y validar anuncios con audiencias sintéticas en POPJAM
Si gestionas campañas para e-commerce, SaaS o varias marcas a la vez, probar cada idea creativa con grupos reales antes de lanzarla es lento y caro. Generamos anuncios en imagen, vídeo, carrusel y animación a partir de una sola URL, y los ponemos a prueba frente a personas sintéticas que simulan la psicografía de una audiencia real, antes de invertir en medios.
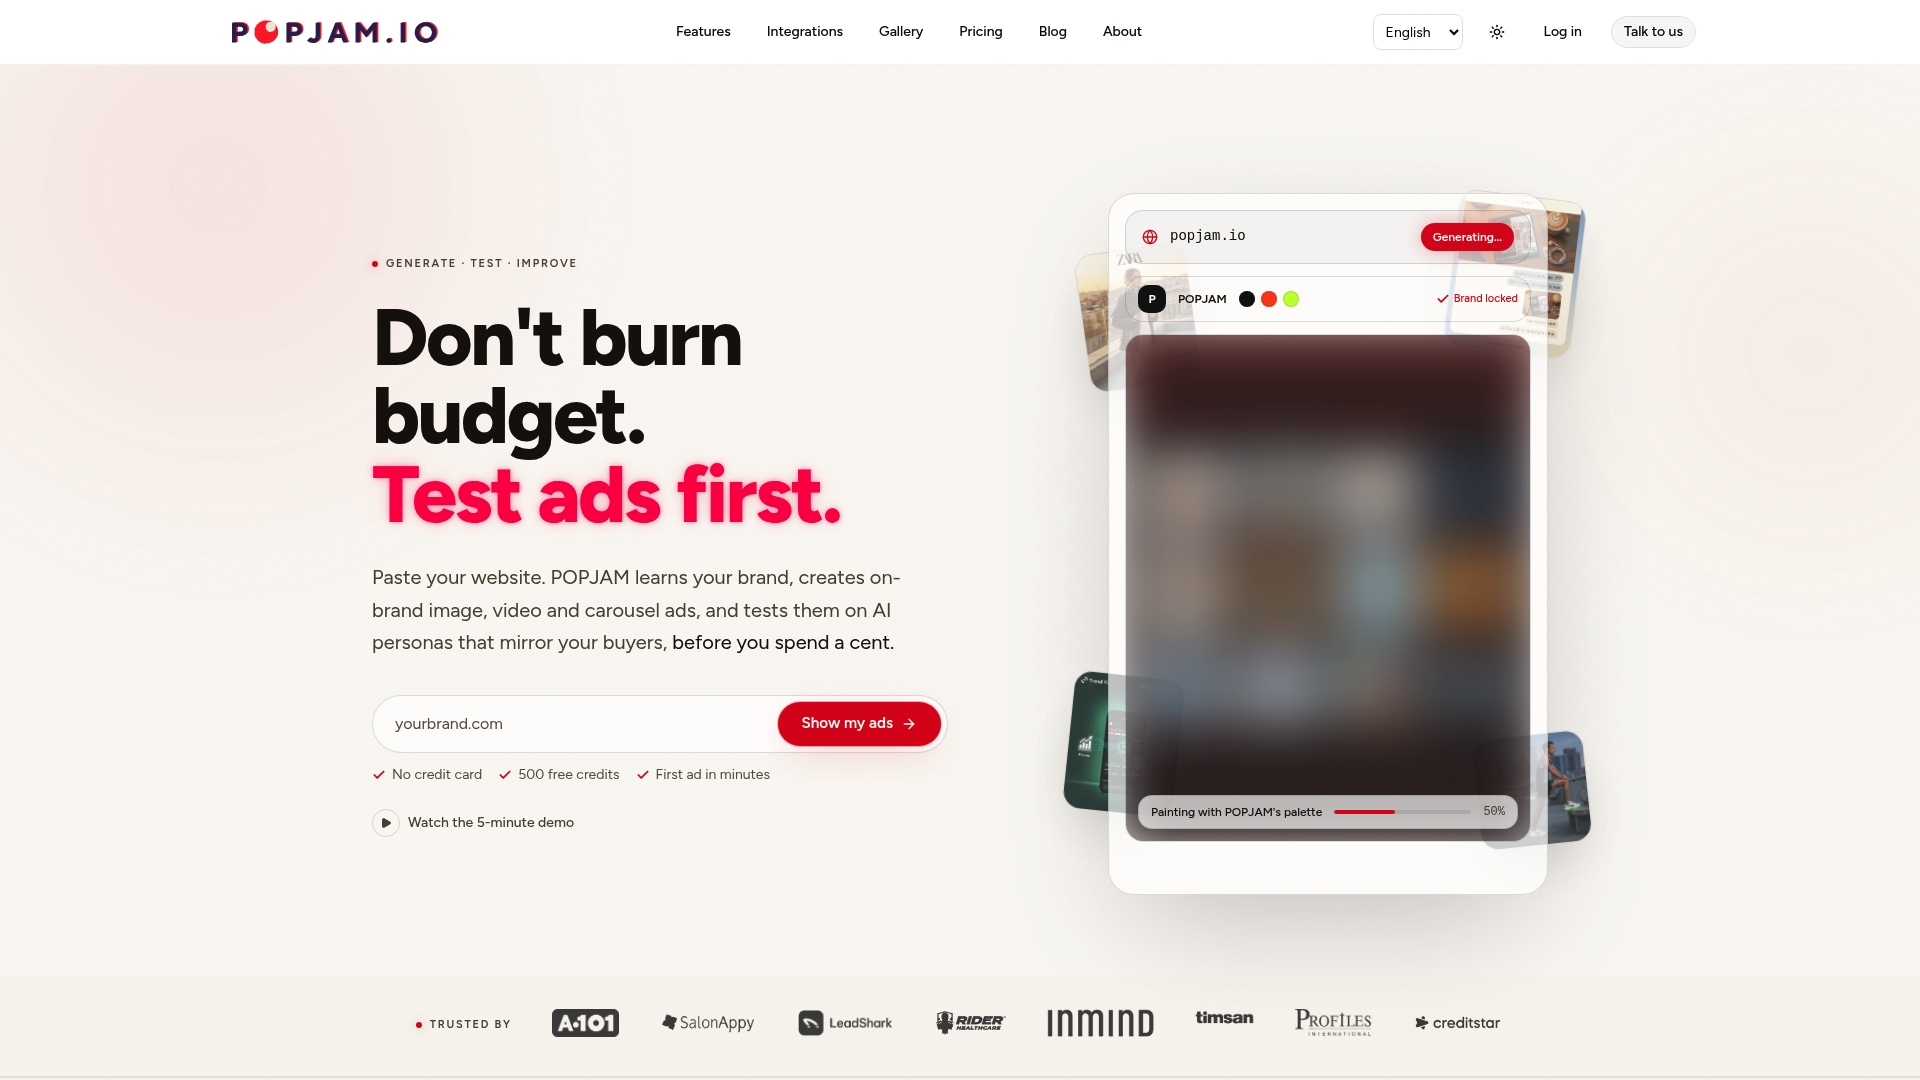
- Generación multiformato adaptada a la marca, lista para exportar a las principales plataformas publicitarias.
- Pruebas con audiencias sintéticas que devuelven retroalimentación psicográfica sobre qué resuena y qué no.
- Integración de catálogo para e-commerce y generación de copys personalizados dentro del mismo flujo.
Esto se traduce en menos gasto desperdiciado en tests reales y en iteraciones más rápidas sobre cada concepto. Puedes revisar los planes y precios o probar directamente el generador de anuncios con IA para ver cómo funciona con tu primera campaña.
Preguntas frecuentes
¿Qué son los datos sintéticos?
Son información generada por modelos de inteligencia artificial que imita patrones de comportamiento o respuestas humanas sin provenir de personas reales. En marketing se usan para simular reacciones de audiencias antes de invertir en campañas reales.
¿Cuáles son los tres tipos de datos sintéticos en investigación de mercados?
Según una taxonomía académica reciente, los tres tipos son respuestas no ancladas, personas de segmento y gemelos digitales individuales.
¿Qué significa información sintética en el contexto del marketing?
Significa datos generados artificialmente que representan el comportamiento o las opiniones probables de una audiencia, usados para probar mensajes y creatividades sin reclutar personas reales en cada iteración. Su utilidad depende de qué tan bien esté anclada esa generación en datos reales previos.
¿Qué son las bases de datos en marketing y cómo se relacionan con los datos sintéticos?
Las bases de datos en marketing almacenan información de clientes, comportamientos de compra e interacciones con campañas, y suelen servir como el dato real que ancla a un modelo sintético. Cuanto más rica sea esa base original, mejor podrá calibrarse la simulación que se construya a partir de ella.
¿Los datos sintéticos reemplazan la investigación de mercado tradicional?
No. Las recomendaciones de firmas como Ipsos apuntan a que los datos sintéticos deben complementar la investigación humana, no sustituirla, con validaciones continuas frente a muestras reales.
Fuentes
- Gain Consumer Insight With Generative AI (MIT Sloan Management Review)
- Synthetic Data in Marketing Research - How to Evaluate and When to Trust (ArXiv / Columbia et al.)
- Differentially Private Synthetic Data | NIST