

Testning av annonstext: ett praktiskt arbetsflöde före lansering
Lär dig testa annonstext effektivt med vår praktiska guide före lansering. Validera budskapen, maximera effekten och skapa resultat.
Testning av annonstext är processen före lansering där budskap och material valideras med representativa målgrupper genom både kvantitativa och kvalitativa metoder, innan en enda dollar i mediebudget avsätts. Det bästa första steget är att välja en primär KPI, bygga tre fokuserade varianter som prövar olika hypoteser och köra ett litet pilotprojekt med en tydlig urvalsregel innan något skalas upp.
Här är planen att börja med:
- Välj primär KPI först. CTR för kännedomsbyggande kampanjer, CVR för resultatdrivna kampanjer. Ett mått styr beslutet.
- Bygg tre varianter med skilda hypoteser. Inte tre versioner av samma rubrik, utan tre olika vinklar: en nyttobaserad, en bevisbaserad och en som bygger på brådska.
- Sätt en urvalsregel före start. Bestäm minsta antal annonsvisningar eller svar som krävs för en vägledande signal och håll fast vid det. Stoppa inte tidigt för att en variant ser bra ut dag två.
Team som vill ha snabbare och billigare signaler före skarpa utgifter kan integrera en plattform för testning före lansering som Popjam. Den kombinerar simulering av syntetiska målgrupper med tidig kvantitativ återkoppling så att ni inte lanserar i blindo.
Viktigaste lärdomarna
Testning av annonstext före lansering är den mest verkningsfulla åtgärden ett marknadsteam kan ta för att minska onödiga utgifter och påskynda kreativt lärande innan kampanjen går live.
| Punkt | Detaljer |
|---|---|
| Definiera primär KPI först | Välj ett mått, CTR för kännedom eller CVR för resultat, innan någon variant utformas. |
| Bygg en variantportfölj med tre roller | Använd Index, som kan skalas, Alpha, med stor uppsida, och Hedge, med fokus på bevis, för olika resultatscenarier. |
| Sätt urvalsstorlek före lansering | Bestäm urvalsstorleken i förväg utifrån budget och mål för att få en vägledande signal. |
| Validera vinnare i två sammanhang | En variant som bara vinner i en placering är kontextberoende, inte universellt skalbar. |
| Använd ett bedömningsschema som första filter | Poängsätt varje material efter inledning, budskapstydlighet, CTA och målgruppsanpassning innan testbudget läggs på svaga varianter. |
| POPJAM för validering före lansering | POPJAM.IO kombinerar AI-generering av annonser, simulering av syntetiska personas och strukturerad poängsättning för att validera material före medieutgifter. |
Innehåll
- Vad är testning av annonstext och när bör den göras?
- Vilka metoder finns för att testa annonstext?
- Vilka textdelar bör man faktiskt testa?
- Så utformar, genomför och fattar man beslut om ett annonstexttest
- Vilka KPI:er bör man mäta och hur tolkas de?
- Vilka verktyg stöder testning av annonstext före lansering?
- Hur omvandlar man testresultat till bättre text?
- Vanliga misstag som förstör annonstexttester
- Hur AI-expertpaneler och syntetiska personas förbättrar utvärdering före lansering
- Etiska överväganden och integritetsfrågor vid testning av annonstext
- Varför ”hitta en vinnare” är fel synsätt för texttestning
- POPJAM.IO sänker kostnaden för lärande innan du spenderar
- Källor
- Vanliga frågor
Vad är testning av annonstext och när bör den göras?
Testning av annonstext, ibland kallat copytestning eller kreativ annonsutvärdering i forskningssammanhang, innebär att budskapsutkast visas för en representativ målgrupp innan ett fullt medieköp görs. Det skiljer sig från A/B-testning på marknaden där verklig budget används för att hitta en vinnare. Testning före lansering är billigare och snabbare och låter er stoppa svaga varianter innan de kostar något.
A/B-testning på marknaden är fortfarande värdefull men är ett annat verktyg. Den används när trafiken räcker för snabb statistisk signifikans, varianterna redan har grundläggande validering och kostnaden för en förlorare är acceptabel. Testning före lansering används när de villkoren saknas.
Testa text före lansering när:
- Ni lanserar ett nytt erbjudande utan historiska materialdata att luta er mot
- Ni går in i ett obekant målgruppssegment med annan psykografi
- Ni köper dyra placeringar som uppkopplad TV eller premiumdisplay där svagt material kostar mycket
- Ni ändrar varumärkespositionering eller ton och behöver veta om den nya rösten når fram
- Ni byter kreativt format helt, till exempel från statiska bilder till video eller från lång till kort text
Ett team som lanserar en SaaS-produkt i en ny bransch kan till exempel testa tre rubrikvinklar i en panelundersökning innan pengar läggs på Google Ads. Undersökningen kostar en bråkdel av en veckas mediebudget och visar vilken vinkel som når fram, förvirrar eller ignoreras helt. Det är den typen av insikt före lansering som kortar lärandekurvan från veckor till dagar.
Vilka metoder finns för att testa annonstext?
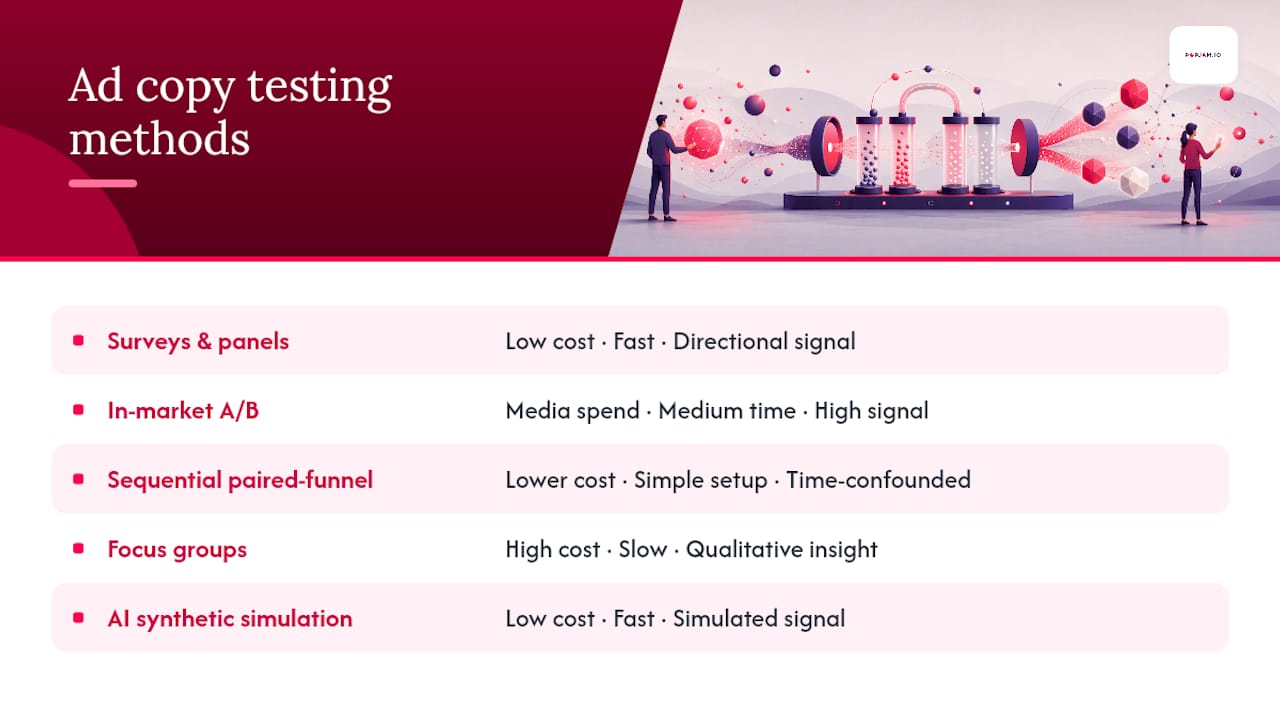
Branschguider identifierar fem huvudmetoder: enkäter och paneler, skarpa A/B- och multivariata tester, fokusgrupper, laboratorietekniker som ögonrörelsemätning och biometri samt AI-driven simulering av syntetiska målgrupper. De passar olika budgetar, tidsplaner och signalbehov.
Enkäter och paneltester av text
Ett strukturerat frågeformulär visar två eller fler annonsvarianter och fångar preferenser, förståelse och reaktioner i fritext. Snabbt, skalbart och billigt. Begränsningen är att uttalade preferenser inte alltid förutsäger beteende. Enkätresultat fungerar därför bäst som vägledande filter, inte som slutgiltig dom.
Skarpa A/B- och multivariata tester
Varianter körs samtidigt i verklig miljö och faktiskt beteende mäts: klick, konverteringar och tid på sidan. Signalkvaliteten är hög eftersom den speglar verkliga beslut. Kostnaden är riktiga medieutgifter och tillräcklig trafik krävs för signifikans. Multivariata tester är kraftfulla men behöver betydligt större urval för att isolera enskilda variablers effekter.
Sekventiella tester med matchade trattar
Kör variant A under en bestämd period, sedan B och jämför. Enklare att sätta upp än verkligt samtidiga A/B-test men känsligt för tidsrelaterade störfaktorer som säsong och nyhetshändelser. Använd bara när samtidig testning inte är möjlig.
Fokusgrupper
Små grupper av målgruppsmedlemmar diskuterar material i ett modererat samtal. Utmärkt för att förstå varför reaktionerna uppstår, särskilt vid varumärkeskänsliga eller känslomässigt komplexa budskap. Dyrt och långsamt, och gruppdynamiken kan dämpa ärliga individuella reaktioner.
Ögonrörelsemätning och biometriska laboratorier
Ögonrörelsemätning visar var uppmärksamheten landar i statiskt material eller video. Biometriska verktyg som galvanisk hudrespons och kodning av ansiktsuttryck mäter emotionell aktivering och känslans positiva eller negativa riktning. Metoderna ger rika psykofysiologiska data men kräver specialutrustning och deltagare och är därför dyrast. De passar bäst för kampanjer med mycket på spel eller beslut om varumärkesplattformen.
Användbarhetstestning
Deltagare interagerar med en annons eller landningssida och berättar samtidigt om sin upplevelse. Särskilt användbart för att hitta text som är tekniskt tydlig men praktiskt förvirrande i sitt sammanhang.
AI-driven simulering av syntetiska målgrupper
AI-modeller simulerar hur definierade målgruppspersonas skulle reagera och poängsätter varianter efter till exempel inledningens styrka, budskapets tydlighet och känslomässigt genomslag, som beskrivs i praktiska artiklar om AI i design. Snabbt, billigt och GDPR-vänligt eftersom inga verkliga respondenter deltar. Avvägningen är att bild- och språkmodeller visar mätbara skillnader mot mänskliga bedömningar. AI-poäng bör därför komplettera mänsklig granskning, inte helt ersätta den.
Kombinerade metoder fungerar bäst. Använd AI-simulering för rangordning och urval, för sedan de två bästa till en panelundersökning för kvalitativt djup och validera till sist vinnaren i ett litet skarpt pilotprojekt. Varje lager ger mer information utan hela kostnaden för att gå direkt till skarp annonsering.
Vilka textdelar bör man faktiskt testa?
De flesta team testar rubriken och stannar där. Då går mycket lärande förlorat. De textdelar som påverkar resultaten mest finns i hela materialet, och isolerad testning ger sköra insikter.
Detaljer som är värda att isolera:
- Rubrik/inledning: Första raden eller de första tre sekunderna. Stoppar den skrollandet?
- Värdeerbjudandets inramning: Börjar ni med resultatet, funktionen eller lättnaden från ett problem?
- Primär nytta: Vilken specifik fördel lyfts fram: hastighet, besparing, status eller trygghet?
- Typ av bevis: Sociala bevis som recensioner och användarantal, auktoritetsbevis som certifieringar och press eller konkreta bevis som exakta siffror och fallstudieresultat?
- CTA-formulering: ”Starta gratis provperiod”, ”Hämta din kostnadsfria rapport” och ”Se hur det fungerar” signalerar olika nivåer av åtagande.
- Ton och röst: Samtalsnära, auktoritativ eller lekfull? Stämmer tonen med målgruppens självbild?
- Längd: Kort och slagkraftig text eller längre förklaring. Beror mycket på placering och steg i tratten.
- Text i bild kontra bildtext: I video och sociala medier påverkar textens placering hur den bearbetas.
- Bildkombination: Samma rubrik fungerar olika bredvid en produktbild, en livsstilsbild eller en datavisualisering.
Forskning om nyskapande och användbarhet visar att kreativ effektivitet beror på båda dimensionerna tillsammans. En annons som är tillräckligt nyskapande för att fånga uppmärksamhet men otydlig om värdet misslyckas ofta med konvertering. Det påverkar testningen direkt: kombinera alltid uppmärksamhetsväckande varianter med tydlighetskontroller.
En enkel testmatris ser ut så här:
| Rubrikvinkel | CTA | Bildstil |
|---|---|---|
| Nyttobaserad: ”Halvera dina annonsutgifter” | ”Börja gratis” | Skärmbild av produktgränssnittet |
| Bevisbaserad: ”Många team litar på oss” | ”Se resultaten” | Kollage med sociala bevis |
| Brådska: ”Erbjudandet slutar på fredag” | ”Säkra din plats” | Nedräkning eller bild som signalerar knapphet |
Tre rubriker, två CTA:er och två bildstilar ger tolv kombinationer i ett fullfaktoriellt test. Det är för många att köra samtidigt med begränsad budget. Välj i stället den dimension ni är mest osäkra på, håll resten konstant och testa en axel åt gången. Testa text som ett system över placeringar och trattsteg, inte som isolerade rader. En rubrik som vinner på Meta kan prestera svagt på LinkedIn eftersom målgruppssammanhanget skiljer sig.
Så utformar, genomför och fattar man beslut om ett annonstexttest
Här kommer det praktiska arbetet. Följ stegen i ordning för att undvika de vanligaste misstagen.
-
Skriv briefen. Ange kampanjmålet, primär KPI, den specifika hypotesen, till exempel ”Vi tror att en nyttobaserad rubrik överträffar en bevisbaserad i kalla målgrupper”, målgruppssegmentet och framgångsgränsen, exempelvis ”Variant B vinner om den ökar CTR med minst 15 % med 95 % konfidens”.
-
Utforma variantportföljen. Tänk i tre roller: Index, den nu bäst presterande eller mest försiktiga texten som kan skalas; Alpha, den mer nyskapande vinkeln med stor uppsida; och Hedge, en bevisrik text med fokus på förtroende. Alla har olika uppgifter. Den här portföljmetoden behandlar testning som en strategi för variation snarare än en skönhetstävling.
-
Lås variabler som inte testas. Samma målgruppsinriktning, budstrategi, placering och materialdimensioner. Bara den testade textdelen ändras. Målgruppsändringar under körning gör hela testet ogiltigt.
-
Välj placeringar och planera valideringssammanhang. En vinnare i ett sammanhang vinner inte nödvändigtvis överallt. Planera att validera den bästa varianten i minst två placeringar eller målgruppssegment före skalning.
-
Sätt urvalsstorlek före start. Tabellen nedan ger praktiska tumregler för tre teststorlekar.
Ett praktiskt ramverk rekommenderar fem rubrikvinklar tillsammans med tre beskrivningstyper, sekventiell eliminering till en vinnare och alltid validering mot efterföljande konverteringsmått, inte bara CTR.
-
Genomför och övervaka utan att ändra. Pausa inte svaga varianter tidigt. Ändra inte målgruppsinriktning eller bud. Plattformarnas inlärningsfönster behöver vanligen 7–14 dagar för att stabiliseras och tidiga data är brusiga.
-
Tillämpa beslutsregler. Sikta på 95 % statistisk konfidens innan en vinnare utses. Vid flera samtidiga varianter används Bonferronikorrigering eller annan justering för multipla jämförelser för att undvika falska positiva resultat. Om två varianter ligger inom varandras felmarginal är det praktiska valet ofta den med bättre kvalitativ återkoppling.
-
Budgetvägledning. Ett litet pilotprojekt kan köras med 500–1 500 $ i mediebudget om CPM är rimlig. Ett medelstort test kräver vanligen 3 000–8 000 $. Stora tester med efterföljande konverteringsvalidering kan kosta minst 15 000 $. Simulering före lansering med exempelvis POPJAM.IO kan minska kostnaden betydligt genom att sålla bort svaga varianter före skarpa utgifter.
Praktiskt tips: Kör den bästa varianten i två målgruppssammanhang samtidigt. En text som vinner i båda är stabilt skalbar. En som bara vinner i ett är kontextberoende och ska användas situationsanpassat, inte rullas ut överallt.
Vilka KPI:er bör man mäta och hur tolkas de?
Rätt primärt mått beror helt på kampanjmålet. Så här kan man tänka utifrån trattens steg.
Uppmärksamhetsmått högst upp i tratten
- CTR, klickfrekvens: Den vanligaste signalen för texteffektivitet i kännedomsfasen. Mäter om rubriken och inledningen är tillräckligt övertygande för att få ett klick.
- Visningsgrad/andel fullständiga videovisningar: Hur långt tittare ser innan de lämnar en videoannons. Stort bortfall under de första tre sekunderna betyder vanligen att inledningen misslyckats.
- Andel som stannar upp: På sociala plattformar andelen användare som pausar vid annonsen. En tidig indikator på inledningens styrka.
Engagemang mitt i tratten
- Tid med materialet: Hur länge användare engagerar sig i interaktiva format eller rich media.
- Mikrokonverteringar: E-postregistreringar, innehållsnedladdningar och genomförda quiz. Användbara när slutkonverteringen är för sällsynt för snabb signifikans.
- Skrolldjup på landningssidan: Om annonsen leder till en lång sida visar skrolldjupet om överensstämmelsen mellan annonstextens och sidans budskap fungerar.
Mått längst ned i tratten
- Konverteringsgrad, CVR: Andelen klick som leder till önskad handling. Det viktigaste måttet för resultatdrivna kampanjer.
- Kostnad per kundanskaffning, CPA: Totala utgifter dividerat med konverteringar. Visar om en CTR-vinnare faktiskt är effektiv.
- Avkastning på annonsutgifter, ROAS: Intäkter per spenderad dollar. Det slutliga resultatmåttet för e-handel.
Varumärkesmått
- Annonsminne: Mäts med varumärkeseffektundersökningar. Minns målgruppen att den sett annonsen?
- Inställning till varumärket: Förbättrade exponeringen uppfattningen om varumärket?
- Känslomässigt genomslag: Kvalitativt eller biometriskt mått på hur annonsen fick målgruppen att känna.
Tolkning av motstridiga signaler är där de flesta team fastnar. Högre CTR men lägre CVR betyder vanligen att texten lockar fel målgrupp eller lovar för mycket. Lägre CTR men högre CVR betyder ofta att texten kvalificerar målgruppen själv, vilket ofta är bättre för resultatdrivna kampanjer. När signaler strider mot varandra väger måttet längre ned i tratten tyngst för resultatmål, medan det tidigare måttet väger tyngst för kännedomsmål.
Beräkna förbättringen genom att dividera skillnaden mellan variant och kontroll med kontrollvärdet och multiplicera med 100. Det är den siffran som spelar roll för affärsbeslut, inte den absoluta skillnaden.
Vilka verktyg stöder testning av annonstext före lansering?
Testverktyg delas in i fem breda kategorier med olika resultatformat och användningsområden.
Enkätpaneler som Attest, Pollfish och Wynter: visar textutkast för utvalda respondenter och samlar kvantitativa preferenspoäng och fritextsvar. Bäst för tidig hypotesrangordning och kontroll av budskapstydlighet.
Plattformar för laboratorieforskning, exempelvis leverantörer av ögonrörelsemätning och biometriska laboratorier: ger uppmärksamhetskartor, poäng för emotionell aktivering och fixeringsdata. Hög signalkvalitet, hög kostnad och långa ledtider.
Plattformar för kreativ analys: analyserar skarpa materialresultat och hittar mönster i det befintliga annonsbiblioteket. Användbara för lärande i efterhand men inte verklig testning före lansering.
AI-simuleringsplattformar: genererar syntetiska målgruppsreaktioner med personamodeller. Snabba, billiga och integritetssäkra. Resultaten omfattar vanligen kvantitativa poäng per dimension och AI-sammanfattad kvalitativ återkoppling. Skillnader mellan modellpoäng och mänskliga bedömningar gör att plattformarna fungerar bäst som filter och prioriteringslager, inte som slutlig beslutsmotor.
Enkla beteendepiloter: små skarpa tester på billiga placeringar, som Facebook Audience Network och Google Display, med strikta budgettak. Verkliga beteendedata till en bråkdel av kostnaden för ett fullskaligt kampanjtest.
Det här bör en testplattform erbjuda:
- Simulering av syntetiska målgrupper med konfigurerbar personapsykografi
- Personabaserad poängsättning över flera kreativa dimensioner
- Kvantitativ och kvalitativ rapportering i en export
- AI-sammanfattning av öppna svar så att ni slipper läsa 500 enskilda svar
- GDPR-medveten simulering som inte kräver verkliga respondentdata
- API-stöd för team som vill integrera testning i sitt kreativa arbetsflöde
POPJAM.IO täcker allt detta. Plattformen genererar varumärkesanpassat material, testar det mot syntetiska köparpersonas före lansering och visar KPI-sammanfattningar tillsammans med AI-sammanfattade öppna svar. Team med kampanjer på Meta, Google, TikTok, LinkedIn och Reddit kan validera material för alla fem innan en dollar spenderas. POPJAMs jämförelseguide ger en fördjupad bild av hur kreativa AI-annonsverktyg står sig på marknaden.
Exempel på plattformsresultat:
KPI-sammanfattning: Variant B får 78/100 för inledningens styrka, 65/100 för budskapstydlighet och 82/100 för CTA-effektivitet. Variant A får 61/100, 71/100 respektive 58/100.
AI-sammanfattad öppen återkoppling: Respondenter beskriver konsekvent variant B:s första rad som ”omedelbart relevant” och ”specifik för min situation”. Den vanligaste kritiken mot A är att nyttan känns generisk. Tre av fem personas anser att CTA:n i A är otydlig om nästa steg.
Den typen av resultat berättar exakt vad det kreativa teamet ska förbättra, inte bara vilken variant som vann.
Hur omvandlar man testresultat till bättre text?
Råpoäng och förbättringssiffror skriver inte bättre annonser. Så här omvandlas resultaten till konkreta ändringar.
När CTR vinner men CVR inte följer med: Inledningen fungerar men brödtexten eller landningssidan levererar inte på löftet. Förstärk överensstämmelsen mellan annons och destination. Om rubriken säger ”Halvera dina annonsutgifter” bör landningssidans rubrik upprepa det exakta påståendet.
När kvalitativ återkoppling motsäger kvantitativ förbättring: Lita på den kvalitativa signalen för diagnos och den kvantitativa för beslut. Om en variant vinner på CTR men beskrivs som ”vilseledande” i fritext bäddar det för kundbortfall och återbetalningar. Åtgärda texten före skalning.
Exempel på små ändringar:
- Rubriken ”AI-verktyg för marknadsförare” blir ”Se vilken annons som vinner innan du spenderar”, ett byte från kategoribeskrivning till konkret resultat.
- Byt bevistyp: ”tusentals litar på oss” blir ”4,8 stjärnor i 1 200 recensioner”. Precisionen brukar höja CVR.
- Att flytta CTA:n från bildtext till text i bild i en videoannons ökar vanligen klickavsikten hos tittare utan ljud, som står för en stor del av konsumtionen i sociala medier.
Klassificera utfall och nästa steg:
- Stabilt skalbar variant: Vinner i flera sammanhang. Skala den och lägg till den som kontrollbaslinje.
- Kontextberoende vinnare: Vinner i en placering eller målgrupp men inte i andra. Använd situationsanpassat. Avveckla den inte men behandla den inte som universell.
- Stor uppsida men instabil: Stark i vissa tester och svag i andra. Värd att behålla som Alpha-variant. Följ noga.
- Förlorare: Presterar konsekvent sämre. Dokumentera vad som inte fungerade och varför och avveckla sedan. Exempelarkivet över förlorare är lika värdefullt som det över vinnare.
Vanliga misstag som förstör annonstexttester
De flesta testmisslyckanden är operativa, inte statistiska. Här är fallgroparna som ger missvisande resultat och hur de undviks.
-
Flera variabler testas samtidigt utan tillräckligt urval. Om rubrik, CTA och bild ändras samtidigt går det inte att veta vilken ändring som gav resultatet. Åtgärd: ändra en primär variabel per test eller använd fullfaktoriell design med tillräckligt stort urval.
-
Tester med otillräcklig statistisk styrka. Att stoppa efter 500 annonsvisningar per variant för att en ser bättre ut är ett vanligt sätt att gå fel. Åtgärd: sätt minsta urvalsstorlek före lansering och rör inte testet innan den nås.
-
Plattformsdriven kombinationsbias. Responsiva annonssystem på Google och Meta kombinerar om rubriker och beskrivningar dynamiskt. Plattformen optimerar alltså ovanpå er egen optimering. Fäst viktiga element eller använd separata annonser vid testning på sådana plattformar så att urvalsbias inte förorenar resultaten.
-
Vinnare valideras inte i flera sammanhang. En vinnare i retargeting misslyckas ofta vid kall prospektering. Åtgärd: validera alltid toppvarianten i minst två sammanhang innan den betraktas som universell vinnare.
-
Kvalitativa signaler ignoreras. En variant som vinner på CTR men ger förvirrade eller negativa fritextsvar är en kortsiktig vinst med långsiktig risk. Åtgärd: läs de öppna svaren. AI-sammanfattning gör det snabbt även i stor skala.
-
Överanpassning till korta toppar. En variant som skjuter i höjden första veckan går ofta tillbaka när målgruppen tröttnar. Åtgärd: kör testet tills trenden planar ut, inte bara under den första toppen.
Verkligt exempel: Ett team som testade Google Ads ändrade inriktningen från bred till exakt matchning dag fyra eftersom tidig CTR såg låg ut. Resultatet blev helt olika målgruppssammansättning i testets två halvor och en meningslös jämförelse. Lösningen är enkel: lås alla variabler som inte testas från start och ändra dem inte förrän testet är avslutat.
Hur AI-expertpaneler och syntetiska personas förbättrar utvärdering före lansering
Den mest reproducerbara utvärderingsmetoden före lansering kombinerar ett strukturerat bedömningsschema med personabaserad simulering. En AI-expertpanel med öppen källkod använder tre personas och åtta dimensioner, viktar inledning och CTA högst och analyserar oenighet mellan personas för att hitta konkreta förbättringar.
De åtta dimensionerna och vad de mäter:
| Dimension | Vad som bedöms | Varför det spelar roll |
|---|---|---|
| Inledning | Stoppar första raden eller bildrutan skrollandet? | Första intrycket avgör om resten av annonsen blir sedd |
| Budskapstydlighet | Är huvudbudskapet omedelbart begripligt? | Förvirrade målgrupper klickar inte |
| Visuell samstämmighet | Förstärker bilden texten eller motsäger den? | Bilder som inte stämmer med texten minskar minnet av budskapet |
| Målgruppsanpassning | Stämmer tonen och språket med personans självbild? | Fel stilnivå signalerar att annonsen inte är för personen |
| Tempo | Motsvarar informationstätheten i video och animation uppmärksamhetsspannet? | För snabbt försämrar förståelsen, för långsamt tappar uppmärksamheten |
| CTA-effektivitet | Är nästa steg tydligt och enkelt? | Svaga CTA:er är den vanligaste orsaken till hög CTR och låg CVR |
| Känslomässigt genomslag | Väcker annonsen den avsedda känsloreaktionen? | Känslor driver minne och delning |
| Effektivitet utan ljud | Förmedlar annonsen budskapet utan ljud? | En stor del av social video ses utan ljud |
Före ett formellt test kan ett bedömningsschema som MOCA, Magnetic, Obvious, Congruent, Actionable, sålla bort svagt material innan det förbrukar testbudget. Material som ligger under gränsen för Magnetic, fångar det uppmärksamhet, eller Obvious, är erbjudandet tydligt, ska inte in i ett skarpt test. Åtgärda det först.
För video och animation granskar bildruteanalys inledningen, vanligtvis bildrutorna 1–3, och CTA-bilden för att se om båda kommunicerar tydligt var för sig. En inledning som kräver ljud för att bli begriplig presterar sämre i miljöer utan ljud.
Förbättringsflöde vid låga bedömningspoäng:
- Inledningspoäng under gränsen: generera nya första rader eller bilder som börjar med ett mer specifikt resultat eller ett starkare mönsterbrott.
- Budskapstydlighet under gränsen: förenkla värdeerbjudandet till en mening. Ta bort text som inte direkt stöder den primära nyttan.
- CTA-poäng under gränsen: testa en mer specifik CTA som anger exakt nästa steg, som ”Ladda ned riktvärdesrapporten för 2026” i stället för ”Läs mer”.
- Målgruppsanpassning under gränsen: anpassa ton, ordförråd och referenser till personans språk. Kör den reviderade texten genom simuleringen igen före skarp testning.
Etiska överväganden och integritetsfrågor vid testning av annonstext
Testning av annonstext involverar verkliga människors uppmärksamhet, data och ibland personuppgifter. Det innebär ansvar som går längre än att bocka av regler.
Informerat samtycke i panelresearch. Vid enkäter och fokusgrupper ska deltagarna veta att de utvärderar annonsmaterial. Att dölja researchens kommersiella syfte bryter mot etablerade forskningsetiska riktlinjer och undergräver förtroendet för marknadsundersökningar.
Dataminimering i beteendepiloter. Skarpa pilotprojekt samlar beteendedata från verkliga användare. Samla bara det som behövs för testfrågan. Använd inte testkampanjer för att bygga målgruppsprofiler utanför testets omfattning.
Syntetiska personas och GDPR. AI-simuleringsplattformar som använder syntetiska personas i stället för verkliga respondenter undviker många frågor om samtycke och dataskydd. POPJAM.IO:s simulering är byggd med hänsyn till GDPR eftersom inga verkliga personuppgifter bearbetas för att skapa personareaktioner. Det är en betydande fördel för team på reglerade marknader eller med känsliga produktkategorier.
Bias i AI-modeller för poängsättning. AI-bedömningsverktyg tränade på historiska annonsresultat kan bära vidare befintliga snedvridningar. De kan gynna kreativa stilar som fungerat för dominerande demografiska grupper och undervärdera material för underrepresenterade målgrupper. Granska modellens resultat över olika segment och komplettera med mänsklig granskning för kampanjer riktade till varierade målgrupper eller minoriteter.
Öppenhet gentemot målgrupper. Annonser som testas och förfinas för maximal övertalningsförmåga medför ett underförstått ansvar att vara korrekta. Text som vinner i känslomässigt genomslag men överdriver produktpåståenden är både ett etiskt problem och en juridisk risk enligt FTC:s riktlinjer om belägg för reklampåståenden.
Varför ”hitta en vinnare” är fel synsätt för texttestning
De flesta team testar annonstext för att hitta en enda vinnare att skala. Det är fel tankemodell och förklarar varför så många ”vinnande” annonser planar ut efter två veckor.
Ett mer användbart synsätt är en variationsstrategi. Ni bygger en portfölj av texter som fungerar tillförlitligt i olika sammanhang, där varianterna har olika uppgifter. En stabilt skalbar variant hanterar kärnmålgruppen. Alpha går in på nya områden. Hedge skyddar resultaten när den skalbara varianten tappar effekt.
Min erfarenhet av tester i flera sammanhang är att förfiltreringen med bedömningsschema skapar större delen av värdet. Team som hoppar över filtret och går direkt till skarp testning slösar en oproportionerligt stor del av budgeten på varianter som en femminutersgranskning hade sållat bort. MOCA är ett snabbt och reproducerbart sätt att göra granskningen. Bedöm varje variant efter Magnetic, Obvious, Congruent och Actionable innan den går in i testet. Allt som misslyckas i minst två dimensioner skrivs om i stället för att testas.
Två konkreta arbetssätt bygger värde över tid: håll alltid en kontrollkampanj igång som referens för nya varianter och underhåll ett exempelarkiv över vinnande mönster, ordnat efter målgruppssegment och trattsteg. Arkivet gör enskilda testresultat till organisationens gemensamma kunskap. Utan det börjar varje ny kampanj från noll.
POPJAM.IO sänker kostnaden för lärande innan du spenderar
Bortslösad annonsbudget kan vanligen spåras till ett beslut: att lansera material som aldrig validerats. POPJAM.IO finns för att fylla den luckan. Plattformen genererar varumärkesanpassat material och testar det mot syntetiska köparpersonas innan mediebudget avsätts. Resultatdrivna marknadsförare får de kvantitativa poäng och den AI-sammanfattade kvalitativa återkoppling de behöver för trygga lanseringsbeslut.
Arbetsflödet är direkt. Generera varianter med POPJAMs AI-annonsverktyg, kör dem genom personasimulering för målsegmenten och få KPI-sammanfattning, bedömningspoäng och fritextåterkoppling i en exporterbar rapport. Ingen panelrekrytering, ingen veckolång väntan på laboratorieresultat och inga gissningar om vilken rubrik köparen uppskattar. Team hos e-handelsvarumärken, SaaS-företag och byråer använder POPJAM för att validera material för Meta, Google, TikTok, LinkedIn och Reddit innan en dollar spenderas på placering. Resultatet är färre bortslösade visningar, snabbare utvecklingscykler och material som når marknaden redan validerat mot verkliga psykografiska profiler. Starta din kostnadsfria provperiod på Popjam och kör ditt första test före lansering i dag.
Källor
- Forskning om nyskapande och användbarhet i kreativ utvärdering, Nature
- Användning av stora modeller för att utvärdera nytt innehåll: en fallstudie
- 5 metoder för att testa annonstext och varför de fungerar
Vanliga frågor
Vad är testning av annonstext?
Testning av annonstext är processen där reklambudskap och material valideras med en representativ målgrupp före lansering. Kvantitativa mått och kvalitativ återkoppling används för att identifiera vilka varianter som mest sannolikt fungerar.
Vad är ett exempel på texttestning i annonsering?
Ett team som lanserar en ny SaaS-produkt testar tre rubrikvarianter i en panelundersökning innan det köper Google Ads-placeringar. Respondenterna bedömer tydlighet och attraktionskraft och fritextsvaren visar vilken inramning av nyttan som bäst når målsegmentet.
Vad är ett B-test av annonstext?
Ett B-test, eller A/B-test, jämför två budskapsvarianter, vanligen en kontroll, A, och en utmanare, B, för att mäta vilken som ger bättre resultat på en definierad KPI som CTR eller CVR. Varianten med statistiskt signifikant förbättring vinner.
Vad är syftet med annonstext?
Annonstext förmedlar ett specifikt budskap till en definierad målgrupp för att driva en mätbar handling, som klick, registrering eller köp. Effektiv text balanserar uppmärksamhetsväckande nyhet med tydlig och användbar information om erbjudandet.
Hur passar POPJAM.IO in i ett testflöde före lansering?
POPJAM.IO genererar materialvarianter och testar dem mot syntetiska köparpersonas före medieutgifter. Plattformen ger strukturerade bedömningspoäng och AI-sammanfattad kvalitativ återkoppling som team kan använda för att välja och förbättra de starkaste varianterna före lansering.