Syntetiska data i marknadsföring: en praktisk guide för marknadsförare
Upptäck hur syntetiska data i marknadsföring kan förbättra dina kampanjer. Använd deras möjligheter effektivt för målgruppssimulering och scenariotestning.
Använd syntetiska data när integritetsbegränsningar, urvalsstorlek eller tidsplan står mellan dig och ett verkligt svar. De fungerar bäst för förtestning av annonsmaterial, målgruppssimulering och stresstestning av kampanjscenarier, och sämst som ersättning för exakt överensstämmelse på individnivå. 4As har dokumenterat hur syntetiska populationer fyller luckor i den bild som paneler och plattformsurval ger. Forskare som testade en integritetsbevarande genereringsprocess fann att syntetiska kampanjer fick 4,1 av 5 jämfört med 4,2 för kampanjer med verkliga data, en skillnad utan statistisk signifikans. Forrester utsåg syntetiska data till en av sina viktigaste framväxande tekniker för 2025.
Så här bör du göra: skala inte upp syntetiska data till produktion direkt. Genomför ett pilotprojekt först.
- Välj ett smalt användningsfall, exempelvis förtestning av annonsmaterial eller ett underrepresenterat segment
- Bestäm en tröskel för beslutsöverensstämmelse innan du tittar på resultaten
- Jämför beslut baserade på syntetiska data med en avskild testmängd av verkliga data, inte bara med frågan ”ser det realistiskt ut?”.
Snabb statistik: I ett ramverk minskade optimerade syntetiska populationer förändringen i rekommendationer från 11,5 % till 1,2 % jämfört med vanliga syntetiska modeller. Det är en betydande förbättring av beslutsstabiliteten när man ska avgöra om något ska gå vidare eller stoppas.
Viktiga lärdomar
Syntetiska data fungerar bäst när de ersätter gissningar i marknadsföringsbeslut med integritetsbegränsningar eller lite data och valideras mot avskilda verkliga testdata innan de styr riktig budget.
| Punkt | Detaljer |
|---|---|
| Börja med beslutsöverensstämmelse | Validera om beslut baserade på syntetiska data stämmer med beslut baserade på verkliga data, inte bara om fördelningarna liknar varandra. |
| Börja med ett smalt pilotprojekt | Avgränsa förtestning eller målgruppssimulering mot avskilda verkliga testdata innan du skalar upp. |
| Se upp med modkollaps | Kontrollera variationen i inbäddningsrymden för att tidigt fånga repetitiva syntetiska resultat med låg variation. |
| Bygg in styrning i dataflödet | Märk syntetiska poster, versionshantera datamängder och skilj testmiljöns data från produktionsdata. |
| POPJAM passar för förtestning | POPJAM testar annonsmaterial mot syntetiska köparpersonas före lansering, i linje med den beslutsöverensstämmelse som guiden rekommenderar. |
Innehåll
- Vad är syntetiska data i marknadsföring?
- Vilka är de bästa användningsfallen för syntetiska data i marknadsföring?
- När bör du använda syntetiska data och när bör du undvika dem?
- Hur genereras syntetiska data?
- Hur validerar du syntetiska data för marknadsföringsbeslut?
- Vilka kontroller för integritet och styrning behövs?
- Hur genomför du ett pilotprojekt med syntetiska data?
- Vad bör du fråga leverantörer av syntetiska data?
- Hur passar POPJAM in i en marknadsföringsstrategi med syntetiska data?
- Vilka begränsningar har syntetiska data i marknadsföring?
- Bör du använda syntetiska data i nästa kampanj?
- Syntetiska data ur ett marknadsföringsperspektiv
- Källor
- Vanliga frågor
Vad är syntetiska data i marknadsföring?
Syntetiska data är artificiellt genererad information som speglar statistiska mönster i verkliga konsument- eller kampanjdata utan att innehålla någon verklig persons uppgifter. Det är inte falska data i betydelsen slumpmässiga eller påhittade. Det är modellerade data, konstruerade för att bete sig som verkliga data i de avseenden som är viktiga för ett beslut.
Marknadsförare arbetar med flera skilda former, och att blanda ihop dem är det snabbaste sättet att använda tekniken fel:
- Strukturerade transaktions- och sessionsloggar: simulerade köpvägar, klickströmmar och beteenden i tratten för testning av analysflöden
- Syntetiska deltagare eller personas: modellerade individer med psykografiska och demografiska egenskaper som används som ersättning för fokusgruppspaneler i stor skala
- Varianter av bild- och videomaterial: genererat annonsmaterial som används för att testa budskap och visuell riktning före medieutgifter
- Syntetiska frågor: genererade sök- eller informationshämtningsfrågor som används för att testa hur väl ett system hittar relevant innehåll, ett arbetssätt som förbättrar efterföljande rangordning när negativa exempel väljs noggrant
- Relationsbaserade, schemastyrda datamängder: kompletta syntetiska databaser som bevarar relationer mellan tabeller, användbara för att testa infrastrukturen innan verkliga data flödar genom den
En syntetisk personapanel ersätter en långsam och dyr fokusgrupp. En syntetisk logg över annonsåterkoppling låter dig stresstesta en materialvariant mot tusen simulerade reaktioner innan en enda dollar når Metas annonsauktion.
Vilka är de bästa användningsfallen för syntetiska data i marknadsföring?
Alla användningsfall ger inte samma värde. Rangordningen nedan speglar var syntetiska data i dag gör mest nytta för marknadsföringsteam.
-
Förtestning av annonsmaterial. Frågan: kommer annonskonceptet att nå fram innan det publiceras? Indata är annonsutkast och definitioner av målsegment. Utdata är förutsagda poäng för engagemang och sentiment i simulerade målgruppsdelar. Den efterföljande mätningen kopplas till faktisk CTR och konvertering när den vinnande varianten lanseras. En integritetsinriktad studie fann att kampanjresultat baserade på syntetiska data låg inom en bråkdel av en poäng från kampanjer med verkliga data i relevansbedömning. Det ger belägg för att simuleringslagret inte behöver offra kvalitet för integritet.
-
Målgruppssimulering för medieplanering. Frågan: hur reagerar olika segment på budgetförändringar mellan kanaler? Indata är historiska utgifter och responskurvor. Utdata är simulerade responsytor för olika scenarier. Här är modellering på populationsnivå särskilt stark eftersom den låter planerare se bortom det panelurval de råkar ha.
-
Simulering och stresstestning av kampanjscenarier. Frågan: vad går sönder om vi utsätter kampanjen för ett extremfall, exempelvis en plötslig prissänkning hos en konkurrent eller en ändring av plattformspolicyn? Företagsteam använder redan syntetiska data för att simulera extremfall och kontrollerade avvikelser för att fånga fel innan de når produktion. Samma logik gäller när kampanjers motståndskraft testas.
-
Komplettering vid kallstart. Frågan: hur testar vi budskap för en helt ny produkt utan historiska data? Syntetiska personas och sessionsloggar ger en startfördelning att testa mot tills verkliga signaler har samlats in.
-
Integritetssäker modellträning. Frågan: kan vi träna prediktiva modeller utan att röra reglerade personuppgifter? Syntetiska datamängder som efterliknar verkliga fördelningar låter datavetenskapsteam arbeta iterativt utan granskning av regelefterlevnaden vid varje experiment.
Praktiskt tips: Välj det första pilotprojektet där du redan har avskilda verkliga testdata att jämföra med. Att pröva förtestning av annonsmaterial mot en kampanj som redan genomförts ger en valideringsbas från dag ett i stället för att vänta veckor på nya resultat från publicerade annonser.
När bör du använda syntetiska data och när bör du undvika dem?
Syntetiska data gör nytta när verkliga data är för känsliga, för få eller för långsamma att samla in. De fungerar dåligt när användaren behöver exakt sanning på individnivå eller när det saknas en tillförlitlig referensfördelning att kalibrera mot.
Använd dem när:
- Integritetskrav begränsar vilka verkliga konsumentdata du lagligen kan komma åt eller kombinera
- Ett målsegment är för litet eller för nytt för att ge ett statistiskt användbart verkligt urval
- Du testar ett tidigt koncept och inte vill förbruka den verkliga målgruppens välvilja på ett grovt utkast
- Du behöver adversariella testscenarier eller extremfall som sällan förekommer i verkliga data men är viktiga för riskplaneringen
Undvik dem eller gå försiktigt fram när:
- Regler uttryckligen kräver verkliga, verifierbara data, exempelvis för vissa finansiella eller vårdrelaterade påståenden
- Beslutet beror på exakt individuellt beteende snarare än mönster på populationsnivå
- Det saknas en trovärdig referensfördelning från verkligheten att kontrollera de syntetiska resultaten mot
Checklista för att gå vidare eller stoppa: om du kan ange vilka avskilda verkliga testdata du ska validera mot och användningsfallet inte kräver säkerhet på individnivå har du grönt ljus för ett pilotprojekt.
Hur genereras syntetiska data?
Marknadsförare behöver inte skriva koden, men kunskap om genereringsmetoden formar vad du bör förvänta dig av resultatet.
Generativa adversariella nätverk (GAN) ställer två modeller mot varandra, en som genererar falska data och en som försöker avslöja dem, tills generatorn producerar övertygande realistiska resultat. GAN är starka på visuellt och bildbaserat syntetiskt material men kan drabbas av modkollaps, där modellen producerar repetitiva variationer i stället för verklig mångfald.
Variationsautoenkodrar (VAE) komprimerar verkliga data till en förenklad representation och återskapar sedan nya exempel från den. De är stabilare än GAN men tenderar att ge något suddigare och mindre skarpa resultat, en verklig avvägning för allt som kunder ska se.
Generering med stora språkmodeller (LLM) skapar syntetisk text, personas och strukturerade poster från prompter. Metoden är flexibel och snabb att bearbeta men starkt beroende av kvaliteten på startdata och promptutformning.
Schemastyrda metoder och mekanismdesign, som Simulas ramverk för datamängdskonstruktion, behandlar hela datamängden som ett konstruktionsproblem i stället för att generera ett exempel i taget. Det ger marknadsförare kontroll på datamängdsnivå över täckning, komplexitet och kvalitet, vilket är mycket viktigare för produktionsanvändning än hur realistisk en enskild post är.
| Utvärderingskriterium | Metod A (GAN/VAE) | Metod B (LLM-baserad) | Metod C (schema/mekanismdesign) |
|---|---|---|---|
| Överensstämmelse med verklig fördelning | Hög för bilder, måttlig för tabelldata | Måttlig, beroende av prompt | Hög, uttryckligen kontrollerad |
| Styrbarhet | Låg till måttlig | Måttlig | Hög |
| Förklarbarhet | Låg | Måttlig | Hög |
| Beräkningskostnad | Hög | Måttlig | Måttlig till hög |
| Beroende av startdata | Högt | Mycket högt | Måttligt |
Hur validerar du syntetiska data för marknadsföringsbeslut?
Den grundläggande valideringsprincipen är beslutsöverensstämmelse: leder den syntetiska datamängden till samma affärsbeslut som en verklig datamängd skulle göra? En datamängd kan se statistiskt övertygande ut och ändå misslyckas med det testet. Utövare har lärt sig att matchning av marginalfördelningar inte räcker i sig, eftersom en syntetisk population kan spegla verkliga medelvärden men missa den underliggande struktur som är relevant för beslutet.
Gå igenom checklistan innan du låter en syntetisk datamängd ligga till grund för ett verkligt budgetbeslut:
- Tester med avskilda testdata. Dela verkliga data i en träningsmängd och en separat testmängd. Generera syntetiska data från träningsdelen och kontrollera sedan om besluten från den syntetiska mängden stämmer med besluten från testmängden.
- Kontroller av modkollaps. Leta efter misstänkt upprepning eller brist på variation i genererade poster, ett vanligt problem med GAN-baserade metoder.
- Variationsmått i inbäddningsrymden. Placera syntetiska och verkliga poster i samma inbäddningsrymd och bekräfta att den syntetiska mängden täcker ett jämförbart brett område, inte ett smalt kluster.
- Stratifierade klusterkontroller. Dela populationen i kända undergrupper och kontrollera att varje undergrupps syntetiska representation följer sin verkliga motsvarighet.
- Mänskliga stickprov. En kunnig granskare går igenom ett urval syntetiska poster för att hitta sådant som ser strukturellt fel ut, även om statistiken godkänns.
Mått som är värda att följa: strategisimuleringens träffsäkerhet, alltså hur nära de simulerade rekommendationerna ligger de verkliga; andelen nya poster, alltså syntetiska poster som inte bara återger träningsmängden; samt motståndskraft mot medlemsinferens, alltså hur svårt det är att bakvägen avgöra om en verklig individs data ingick i modellunderlaget.
Snabb statistik: I PolicySynth-ramverket minskade optimerade syntetiska populationer förändringen i rekommendationer från 11,5 procentenheter till 1,2 jämfört med ooptimerade syntetiska modeller. Det är ett starkt argument för att bygga in testning av beslutsöverensstämmelse i varje pilotprojekt i stället för att enbart lita på liknande fördelningar.
Praktiskt tips: *Bygg en liten referensmängd för utvärdering med 30 till 50 verkliga utfall innan du genererar en enda syntetisk post.
Vilka kontroller för integritet och styrning behövs?
Be varje leverantör om bevis, inte löften, på tre områden: testning av motståndskraft mot medlemsinferens, dokumenterad andel nya poster och tydlig datalinje som visar exakt vilka verkliga data som användes för att träna den syntetiska modellen.
Bygg internt in följande vanor i arbetsflödet:
- Märk varje syntetisk post med en metadataflagga, exempelvis
source = synthetic, så att den aldrig obemärkt hamnar i produktionsanalysen - Versionshantera syntetiska datamängder som kod, med tydligt genereringsdatum och modellversion
- Begränsa åtkomsten till processer för syntetisk generering på samma sätt som åtkomsten till verkliga kunddata
- Ha en separat testmiljö så att syntetiska data och produktionsdata aldrig av misstag delar tabell.
Ha ett kort underlag redo för juridik och regelefterlevnad: vilken genereringsmetod som användes, vilka integritetstester som kördes, datalinjen och en sammanfattning av valideringsresultaten. Det underlaget är vanligtvis allt ett revisionsteam behöver för att godkänna ett pilotprojekt.
Hur genomför du ett pilotprojekt med syntetiska data?
Ett pilotprojekt behöver en fast avgränsning, en namngiven ansvarig från varje funktion och ett absolut slutdatum. Involvera dataingenjörer för dataflödet, analytiker för valideringen, juridik för integritetsgranskningen och den som ansvarar för det kreativa beslut eller mediebeslut som projektet ska stödja.
- Definiera en smal affärsfråga som pilotprojektet måste besvara
- Identifiera den minsta verkliga datamängd som behövs som träningsunderlag och avskild testmängd
- Välj en genereringsmetod som passar användningsfallet, inte den mest uppseendeväckande tekniken
- Bestäm trösklar för beslutsöverensstämmelse innan genereringen börjar
- Gå igenom valideringschecklistan och jämför med de avskilda testdata
- Besluta att skala upp, bearbeta eller stoppa utifrån den förutbestämda tröskeln, inte magkänsla
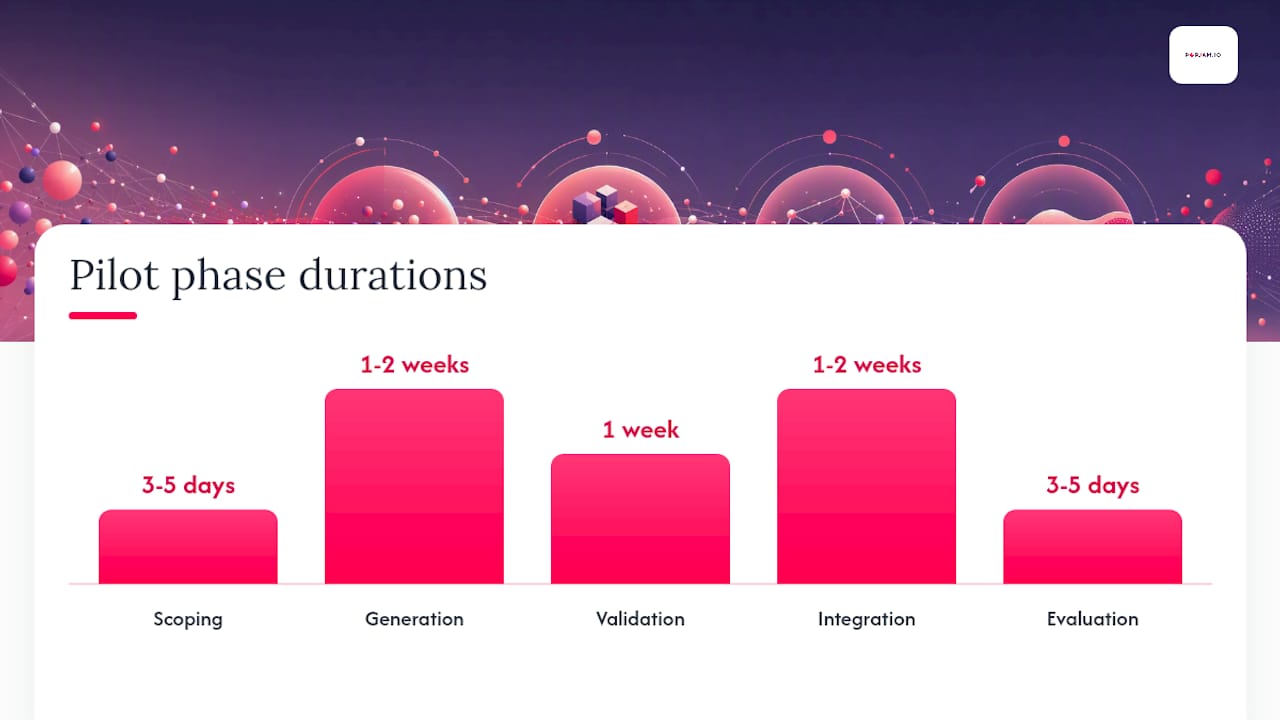
| Fas | Typisk längd | Viktigaste resultat |
|---|---|---|
| Avgränsning | 3 till 5 dagar | Definierad fråga, framgångströskel och namngivna ansvariga |
| Generering | 1 till 2 veckor | Första utkastet till syntetisk datamängd |
| Validering | 1 vecka | Poäng för beslutsöverensstämmelse mot avskilda testdata |
| Integration | 1 till 2 veckor | Koppling mellan dataflödet och befintliga analysverktyg |
| Utvärdering | 3 till 5 dagar | Beslut att skala upp, bearbeta eller stoppa |
Behandla framgång som ett binärt utfall kopplat till tröskeln från avgränsningen, inte som en vag känsla av att ”data såg bra ut”.
Vad bör du fråga leverantörer av syntetiska data?
Leverantörspresentationer är fulla av självsäkra påståenden. Din uppgift är att be om bevis som håller för granskning.
- Hur testar ni motståndskraft mot medlemsinferens, och kan ni visa resultaten?
- Hur stor är andelen nya poster och hur mäter ni den?
- Hur ofta uppdateras datamängden och vad utlöser en ny generering?
- Kan ni tillhandahålla en reproducerbar valideringsrapport, inte bara ett sammanfattande påstående?
- Hur integreras era resultat med våra befintliga analys- och materialtestverktyg?
Bedöm varje leverantör utifrån några konkreta dimensioner i stället för att enbart lita på presentationen.
| Dimension | Vad du ska leta efter | Svag signal |
|---|---|---|
| Validering | Reproducerbara rapporter om beslutsöverensstämmelse | Enbart påståenden om att det ”ser realistiskt ut” |
| Transparens | Tydlig dokumentation av genereringsmetoden | Vaga formuleringar om ”egenutvecklad AI” |
| Integration | Fungerar med befintliga analysverktyg | Kräver ett fullständigt plattformsbyte |
| Kostnad | Användningsbaserade priser eller prisnivåer som passar pilotprojektets omfattning | Otydlig prissättning enbart för storföretag |
För ett strukturerat sätt att bygga in dessa utvärderingskriterier i ett bredare testprogram är Kontrol Medias experimentramverk för tillväxtmarknadsföring en användbar referens för att säkerställa noggrannhet innan du börjar poängsätta leverantörer.
Hur passar POPJAM in i en marknadsföringsstrategi med syntetiska data?
POPJAM motsvarar direkt de mest värdefulla användningsfallen ovan. Det skapar annonsmaterial som följer varumärket och testar det mot syntetiska köparpersonas innan något når en publicerad kampanj. Det är precis den kombination av förtestning och målgruppssimulering som marknadsförare behöver för att minska risken i utgifterna.
Ett avgränsat pilotprojekt ser ut så här:
- Ladda upp varumärkesriktlinjer och en uppsättning annonsutkast
- Generera syntetiska personareaktioner i de segment som är viktiga för dig
- Granska psykografisk återkoppling och signaler om annonsslitage före lansering
- Jämför den högst rankade variantens verkliga resultat med den syntetiska förutsägelsen
Mätresultat att lyfta: team som använder datastödd testning av annonsmaterial rapporterar betydande ROI-förbättringar när kreativa beslut grundas på syntetisk återkoppling i stället för gissningar. Mönstret är förenligt med principen om beslutsöverensstämmelse som går genom hela guiden.
Vilka begränsningar har syntetiska data i marknadsföring?
Syntetiska data misslyckas på förutsägbara sätt och varje problem har en tydlig lösning.
- Överanpassning till startdata: den syntetiska mängden återger bara träningsdata i stället för att generalisera. Åtgärda genom att öka variationen i startdata och kontrollera andelen nya poster.
- Att enbart lita på liknande fördelningar: en datamängd kan se statistiskt korrekt ut men ändå leda till fel beslut. Åtgärda med testerna av beslutsöverensstämmelse från tidigare avsnitt.
- Modkollaps: repetitiva resultat med låg variation, vanligt med GAN-baserade metoder. Åtgärda med variationskontroller i inbäddningsrymden innan du litar på resultaten.
Bestäm en uppdateringstakt och en granskningskontroll för varje syntetisk datamängd i produktion. Konsumentbeteende förändras med säsongerna och en syntetisk modell tränad på förra årets mönster blir obemärkt inaktuell.
Bör du använda syntetiska data i nästa kampanj?
Syntetiska data förtjänar en plats bland marknadsföringsverktygen när de avgränsas tydligt, valideras mot avskilda verkliga testdata och behandlas som ett levande verktyg snarare än en engångsexport. De ersätter inte verkliga konsumentundersökningar. De minskar risken i beslut som du annars skulle fatta på instinkt eller med ett urval med otillräcklig statistisk styrka.
Tre nästa steg att prioritera:
- Genomför ett smalt pilotprojekt det här kvartalet med en förutbestämd tröskel för beslutsöverensstämmelse
- Bygg valideringskontrollen innan du utvärderar någon leverantörs resultat
- Välj ut två eller tre leverantörer med bedömningsmallen ovan, inte den mest imponerande demonstrationen
Börja med ett POPJAM-pilotprojekt kring ett enda kreativt beslut som du redan planerar att fatta.
Syntetiska data ur ett marknadsföringsperspektiv
Den vanliga presentationen av syntetiska data lutar för tungt mot realism, som om en datamängd som ”ser ut som” verkliga konsumenter automatiskt är användbar. Det är den inte. Forskningen om beslutsöverensstämmelse gör en tydligare poäng: en syntetisk population kan träffa varje marginalfördelning rätt och ändå leda till fel annonsmaterial eller budgetfördelning, eftersom strukturen som driver verkliga beslut är mer subtil än aggregerad statistik.
Det som underskattas är hur lätt tekniken går att pröva i pilotprojekt. Marknadsförare behöver inte ett datavetenskapsteam för att testa ett annonskoncept mot syntetiska personas den här månaden. De behöver en smal fråga, avskilda verkliga testdata och disciplinen att bestämma en tröskel innan de tittar på resultaten. De flesta team hoppar över den sista delen och börjar rättfärdiga det tal som kommer ut.
Här invänder jag mot standardråden: jaga inte den tekniskt mest avancerade genereringsmetoden först. Prioritera valideringsdisciplinen. En korrekt validerad schemastyrd datamängd slår en avancerad LLM-genererad mängd som ingen har jämfört med verkligheten.
Källor
- Tillförlitliga syntetiska data som beslutsstöd för kampanjer: strategisimuleringens träffsäkerhet och PolicySynth-ramverket
- Bygg en företagsstrategi för syntetiska data med Amazon Bedrock
- Fyll luckorna: hur syntetiska data förändrar marknadsföringslandskapet
- Bevara integritet i marknadsföring: en jämförande studie av syntetiska data för generering av personaliserade kampanjer
- Utforma syntetiska datamängder för verkligheten: mekanismdesign och resonemang från grundprinciper
- Varför syntetiska data kan bli annonseringens nästa stora satsning
Vanliga frågor
Vad betyder ”syntetiska data”?
Syntetiska data är artificiellt genererad information som är utformad för att spegla statistiska mönster i verkliga data, exempelvis konsumentbeteende eller kampanjreaktioner, utan att innehålla någon verklig individs uppgifter.
Vilka exempel finns på syntetiska data i marknadsföring?
Exempel är syntetiska köparpersonas för målgruppssimulering, syntetiska loggar över annonsåterkoppling för materialtestning, syntetiska transaktionsloggar för testning av dataflöden och syntetiska frågor för testning av informationshämtning och sökning.
Hur genererar jag syntetiska data?
Vanliga metoder är generativa adversariella nätverk och variationsautoenkodrar för bild- och tabelldata, stora språkmodeller för text- och personagenerering samt schemastyrd mekanismdesign för kompletta produktionsdatamängder. Varje metod innebär olika avvägningar mellan överensstämmelse, kontroll och kostnad.
Är ChatGPT tränad på syntetiska data?
Stora språkmodeller, inklusive ChatGPT, har använt syntetiska data som en del av bredare träningsprocesser, särskilt för uppgifter som att generera syntetiska frågor och strukturerad text. Den exakta sammansättningen av träningsdata för en viss modellversion är dock inte fullständigt offentliggjord.
Hur vet jag om syntetiska data är tillförlitliga för ett marknadsföringsbeslut?
Kontrollera beslutsöverensstämmelsen först: gör ett test med avskilda testdata för att se om beslut från syntetiska data stämmer med beslut från verkliga data. Bekräfta sedan resultaten med kontroller av modkollaps och variation innan du litar på dem för budgetbeslut.
Rekommenderad läsning
- Vad är datastödd marknadsföring? Nå högre ROI | POPJAM.IO-bloggen
- Datastött annonsmaterial: öka kampanjens ROI med 47 % | POPJAM.IO-bloggen
- Generativ AI för marknadsföring: din handbok för 2026 | POPJAM.IO-bloggen
- Vad är syntetiska personas? AI-personas för marknadsföring | POPJAM | POPJAM.IO-bloggen