För marknadsförare: rangordna produktbilder med personor innan du spenderar en dollar
Förtesta produktbilder med kalibrerade personor och få rangordnade prognoser innan du spenderar annonsbudget. Lär dig utforma opartiska varianter, validera...
Testning av produktbilder innebär att köra annonsbilder genom kalibrerade syntetiska köparpersonor före lanseringen. Då får du en rangordnad prognos över vilken bild som vinner i stället för en gissning. Det minskar slöseri med mediebudget genom att göra valet av annonsmaterial till ett databaserat steg i stället för en slantsingling. Haken: resultatet är en rangordnad hypotes, ingen garanti, så du behöver fortfarande validera vinnaren med riktiga annonsutgifter. Verktyg som POPJAM bygger in just detta arbetsflöde i en enda plattform.
Snabbversion:
- Testning av produktbilder ger rangordnade prognoser för annonsbildernas resultat, men kräver fortfarande validering i skarpt läge innan hela mediebudgeten används.
- Varianterna bör bara ändra en variabel i taget, med 3 till 5 alternativ i testet för tydliga resultat som går att agera på.
- Syntetiska paneler byggda på verkliga målgruppsdata förutsäger engagemang med ungefär 73 till 95 procents träffsäkerhet, men bör behandlas som hypoteser.
- Ett korrekt upplägg innebär att definiera mål, målgrupp och format i förväg samt löpande kalibrera om prognoserna med verkliga resultat.
- Att kombinera syntetiska förtester med återkoppling från verkliga kunder förbättrar träffsäkerheten och minskar risken att lansera ineffektivt annonsmaterial.
Innehåll
- Vad är testning av produktbilder och när bör du använda det?
- Hur förtestar du produktbilder steg för steg?
- Vilka bildsignaler påverkar faktiskt prognospoängen?
- Hur tolkar du förtesternas rangordningar utan att lita för mycket på dem?
- Hur utformar du opartiska, statistiskt hållbara testvarianter?
- Vilka verktyg och plattformar hanterar testning av produktbilder?
- Vilka är de vanligaste misstagen vid testning av produktbilder?
- Hur bör du kombinera kundåterkoppling med syntetisk testning?
- Vilka etik- och integritetsfrågor följer med testning mot syntetiska personor?
- Varför rangordningstänkande slår jakten på perfekta prognoser
- Testa produktbilderna innan du spenderar en dollar på medier
- Källor
- Vanliga frågor
Vad är testning av produktbilder och när bör du använda det?
Här är en checklista du kan gå igenom under nästa timme, innan teamet som skapar annonsmaterial rör ett enda annonskonto. Testning av produktbilder fungerar bäst när du har riktiga varianter redo och ett tydligt beslut att fatta, inte när du letar inspiration.
Börja med detta:
- Lås målet och kanalen först. Ett test av förmågan att stoppa skrollandet på TikTok och ett test av klickfrekvens i Google Sök behöver olika bedömningskriterier. Bestäm därför vad du optimerar innan du genererar något.
- Förbered några bildvarianter och skriv ned exakt vilken enskild variabel som ändras mellan dem: bakgrund, närvaro av en modell, textlager eller färgbehandling.
- Definiera grundsignalerna för målgruppen. Åldersspann, köpintention, kännedom om kategorin och plattformsvanor påverkar hur en syntetisk panel bör byggas för att spegla dina verkliga köpare.
- Samla metadata. Plattform, kampanjmål och eventuella begränsningar i målgruppsstyrningen, som åldersgränser och regionala restriktioner, påverkar hur en prognosmodell väger bilden.
- Bestäm beslutsregeln i förväg. Bestäm redan nu att du ska lansera den högst rankade varianten med en begränsad testbudget och ha tvåan i reserv, så att ingen börjar diskutera när poängen har kommit in.
Hoppa över förtestning när du fortfarande utforskar tidiga koncept med grova skisser. Den gör störst nytta när materialet nästan är färdigt och en verklig mediebudget står på spel.
Hur förtestar du produktbilder steg för steg?
Arbetsflödet bakom testning med syntetiska personor följer en återkommande process i fem steg: generera varianter, bygg panelen, poängsätt, lansera vinnaren och validera i skarpt läge, enligt neuroflashs testramverk. Så här ser varje steg ut för en annons med produktbild.
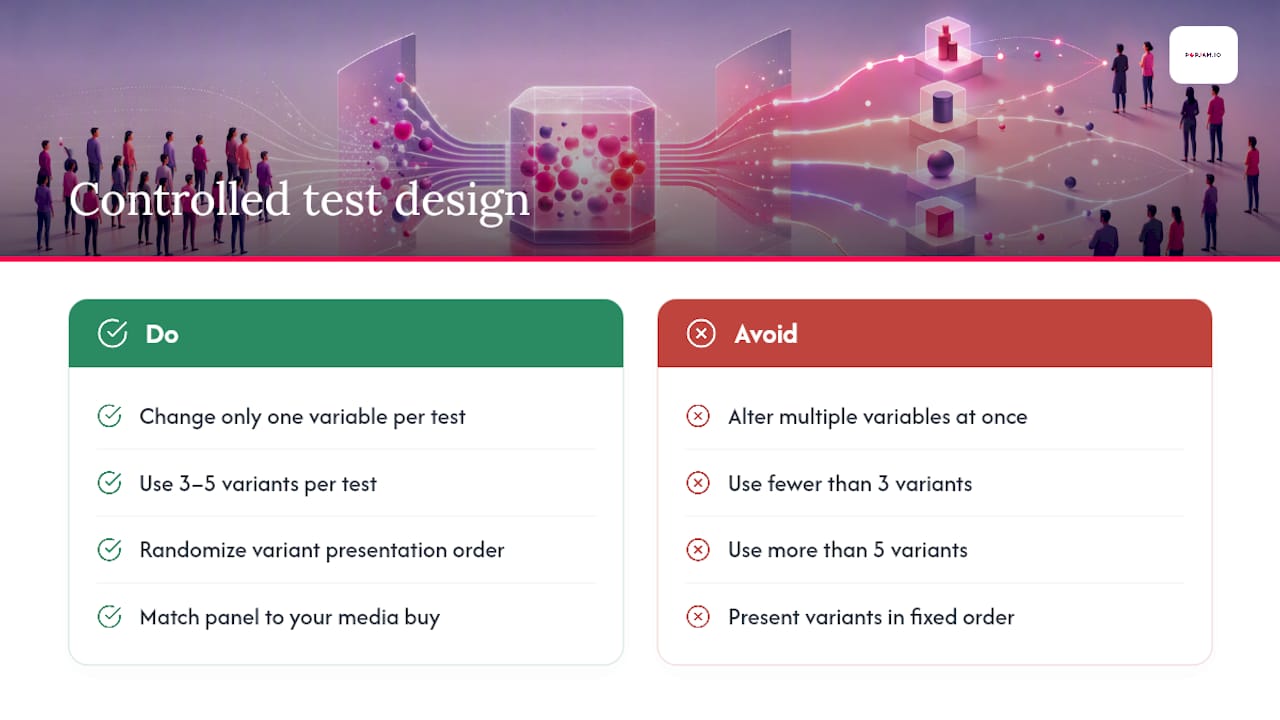
Skapa 3 till 5 nästan färdiga bildvarianter och ändra en variabel i taget. Om du byter bakgrund OCH modell OCH textlager i samma variant får du aldrig veta vilken ändring som påverkade poängen. Isolera variabler precis som i alla kontrollerade experiment.
Bygg en kalibrerad panel av syntetiska personor som speglar det segment annonserna faktiskt riktas till. Det här är ingen generisk ”köparpersona”. Den byggs utifrån de psykografiska och demografiska egenskaperna hos målgruppen du faktiskt riktar dig till i Meta Ads Manager eller Google Ads. Paneler av digitala tvillingar som dessa kan ge rangordnade prognoser på några minuter. Det gör förtestningen tillräckligt snabb för en verklig produktionskalender, enligt GWI:s forskning om syntetiska personor.
Kör varianterna genom panelen och samla prognospoäng för engagemang, klickfrekvens och konverteringsintention. Du vill ha en rangordnad lista, inte betyget godkänd eller underkänd.
Välj den högst rankade varianten för lansering med en liten, kontrollerad budget och ha tvåan redo. Lägg inte hela månadens budget på den främsta prognosen första dagen.
Jämför prognosen med det faktiska resultatet i skarpt läge och logga skillnaden. Det här är steget de flesta team hoppar över, och det som gör varje framtida förtest mer träffsäkert.
Proffstips: Ställ avgränsade frågor till den syntetiska panelen, exempelvis om en framträdande produktbild slår en livsstilsbild för just den här målgruppen, i stället för en vag instruktion som ”kommer den här annonsen att vinna?”. Specifika frågor ger specifika rangordningar som går att agera på.
Vilka bildsignaler påverkar faktiskt prognospoängen?
Alla pixlar är inte lika viktiga. Prognosmodeller väger en ganska enhetlig uppsättning visuella signaler och metadata. Om du förstår dem kan du prioritera vilka ändringar du testar först i stället för att justera allt samtidigt.
- Komposition och fokuspunkt. Var blicken landar först, och om det är på själva produkten, driver en stor del av prognosen.
- Kontrast och bakgrundsbehandling. En produkt som visuellt skiljer sig från bakgrunden får nästan alltid högre poäng än en som smälter in.
- Ansiktens närvaro och placering. Ansikten kan öka uppmärksamheten, men ett ansikte för nära produkten eller rubriken tenderar att dra fokus från det du faktiskt säljer.
- Textlagrets täthet. Mycket text förstör läsbarheten i mobilflöden, där huvuddelen av materialet faktiskt ska visas.
- Anpassning till plattform och format. En kvadratisk produktbild för ett flöde presterar inte likadant som en 9:16-beskärning för Stories eller Reels. Att ange den avsedda plattformen och formatet när materialet poängsätts förbättrar prognosernas träffsäkerhet mätbart.
- Inskickade metadata. Uppgifter om mål, kanal och målgrupp som du bifogar bilden gör modellens prognoser skarpare.
Prognossystem som kombinerar datorseende med naturlig språkbehandling kan nå ungefär 73 % träffsäkerhet när de identifierar material i den bästa kvartilen, om signalerna viktas korrekt. Det ger en meningsfull fördel jämfört med att gissa, men ingen säkerhet. Just därför är nästa steg så viktigt.
Hur tolkar du förtesternas rangordningar utan att lita för mycket på dem?
Behandla varje förtestresultat som en hypotes om rangordning, inte en absolut prognos. Experter som studerar relativa och absoluta bedömningssystem finner konsekvent att relativa rangordningar står sig bättre mot verklighetens variation än en enskild förutsagd siffra. Ett förtest som säger ”Variant B slår Variant A” är mer tillförlitligt än ett som säger ”Variant B får 4,2 % CTR”.
Välkalibrerade syntetiska paneler kan i vissa studier nå 85 till 95 procents samlad överensstämmelse med paneler av verkliga människor. Det är starkt, men lämnar fortfarande ett faktiskt gap. Därför är det viktigt att sluta återkopplingscirkeln:
- Bestäm ett valideringsfönster, vanligtvis 3 till 7 dagar med riktiga annonsutgifter, och en minsta urvalsstorlek innan du litar mer på verkliga resultat än prognosen.
- Logga förutsagd poäng mot verkligt resultat varje gång och leta efter en återkommande avvikelse åt samma håll snarare än enstaka brus.
- Kalibrera om vid säsongsskiften, förändringar i kategorin eller helt nya stilar på annonsmaterial som panelen inte har sett tidigare.
- Kör ett litet skarpt A/B-test även på det högst rankade materialet när insatsen är så stor att ett felaktigt beslut skulle bli dyrt.
Proffstips: Ett gap mellan prognos och verklighet är inte ett misslyckande för modellen. Det är signalen som visar när du behöver kalibrera om, vilket är hela poängen med att logga resultat från början.
Hur utformar du opartiska, statistiskt hållbara testvarianter?
Dålig utformning av varianter är den snabbaste vägen till ett säkert svar på fel fråga. Ändra en variabel per test, alltid. Om du ändrar bakgrund, rubrik och produktvinkel samtidigt säger en högre poäng inget användbart om vilken ändring som faktiskt orsakade den.
Håll antalet varianter mellan 3 och 5. Färre än tre ger svag åtskillnad mellan signalerna. Fler än fem sprider den syntetiska panelens uppmärksamhet för tunt och gör det svårare att få en tydlig vinnare. Slumpa ordningen som varianterna visas för panelen i, eftersom presentationsordningen i det tysta kan snedvrida tidiga resultat till förmån för den bild som visas först.
Anpassa panelens sammansättning till ditt faktiska medieköp. Om den riktiga kampanjen riktar sig till kvinnor mellan 25 och 34 år i USA som handlar på mobilen ger en generisk eller felmatchad panel en rangordning som inte har något med dina verkliga köpare att göra. Urvalsstorleken spelar också roll. Ett förtest mot en liten panel kan se statistiskt prydligt ut samtidigt som det har stora, oredovisade felmarginaler.
Håll slutligen testförhållandena konstanta. Om Variant A poängsätts mot målet ”engagemang” och Variant B mot ”konverteringsintention” jämför du inte bilder utan olika frågor. Lås målet, kanalen och målgruppsdefinitionen innan du kör en enda variant genom panelen.
Vilka verktyg och plattformar hanterar testning av produktbilder?
Kategorin kan delas upp i några praktiska grupper. Heltäckande plattformar för annonsmaterial genererar annonsvarianter och kör dem genom syntetiska personapaneler i ett steg. Det är den snabbaste vägen när du behöver både materialet och poängen. POPJAM hör till den gruppen och kombinerar AI-genererat annonsmaterial med psykografisk återkoppling från syntetiska köparpersonor innan något går live.
Fristående plattformar för syntetiska målgrupper fokuserar enbart på poängsättningen. Du tar med eget material och får rangordnade prognoser mot en kalibrerad panel. De passar team med starka interna designresurser som bara behöver valideringssteget.
Allmänna resurser om visuell komposition kompletterar verktygslådan. Att förstå principerna för visuellt berättande hjälper teamet skapa bättre varianter redan innan de når en bedömningspanel. Om den förtestade vinnaren driver trafik till en produktsida kan bildtestning kombineras med optimering av konverteringsgraden i landningsupplevelsen för att sluta cirkeln mellan annonsklick och försäljning.
För team som jämför alternativ brett ger en jämförelse sida vid sida av AI-verktyg för annonsmaterial en bild av avvägningarna mellan genererings- och testfunktioner. De är värda att förstå innan du avsätter budget till någon enskild plattform.
Vilka är de vanligaste misstagen vid testning av produktbilder?
Det största misstaget är att behandla en förtestpoäng som en lanseringsgaranti i stället för en rangordning. Team som helt hoppar över validering i skarpt läge eftersom ”modellen sa att Variant C vinner” blir överraskade när verkliga resultat avviker från prognosen, särskilt i kategorier med snabba trender eller säsongsskiften.
Att ändra för många variabler samtidigt kommer tätt därefter. Om teamet testar fem helt olika koncept i stället för fem variationer på ett koncept lär ni er nästan ingenting om varför ett vinner.
En felmatchad eller generisk syntetisk panel är ett annat vanligt fel. En panel som inte speglar de verkliga målgruppsparametrarna ger säkra, prydliga rangordningar som helt enkelt inte fungerar i den faktiska kampanjen. På samma sätt glömmer team ibland att skicka med metadata om plattform och format vid poängsättningen. Då berövas modellen sammanhang den behöver, eftersom plattformsanpassning är en av de starkare tillgängliga prognossignalerna.
Att hoppa över omkalibreringen är slutligen ett misstag som märks långsamt. En modell som inte regelbundet kontrolleras mot verkliga resultat tappar gradvis träffsäkerhet när kategorin, konkurrenterna och målgruppens vanor förändras. Statiska modeller försämras. Det går inte att komma runt behovet av att löpande jämföra prognos med verklighet.
Hur bör du kombinera kundåterkoppling med syntetisk testning?
Förtestning med syntetiska personor är snabb och billig, men ersätter inte att lyssna på verkliga kunder. Metoderna fungerar bäst tillsammans, inte genom att välja den ena framför den andra.
Använd syntetisk förtestning först för att minska ett brett fält av koncept till de två eller tre främsta kandidaterna. Där spelar snabbheten störst roll och insatsen är lägst. Ta sedan in verklig kundåterkoppling i valideringssteget genom enkäter efter köp, återkommande teman i supportärenden eller kommentarer på publicerade inlägg i sociala medier. Gör en rimlighetskontroll av om den syntetiska rangordningen motsvarar det verkliga köpare säger att de reagerar på.
Kvalitativa signaler fångar sådant syntetiska paneler ibland missar: kulturella nyanser, interna skämt kring ett varumärke eller en produktdetalj som bara blir begriplig för någon som faktiskt har hållit i varan. Om kundtjänsten gång på gång hör att människor älskar ett visst färgalternativ är det en verklig signal värd att använda i nästa omgång bildvarianter, även om den syntetiska panelen inte flaggade den först.
De team som får mest ut av kombinationen arbetar i en tät återkopplingscykel: syntetiskt förtest för att begränsa urvalet, ett litet skarpt test för att bekräfta och därefter kundåterkoppling för att förklara varför vinnaren vann.
Vilka etik- och integritetsfrågor följer med testning mot syntetiska personor?
Syntetiska personor byggs av aggregerade beteendemässiga och demografiska mönster, inte verkliga uppgifter om enskilda konsumenter kopplade till ett namn eller konto. Den skillnaden spelar roll för hur teamet bör beskriva metoden internt och för kunder, eftersom den undviker integritetsriskerna med att testa mot riktiga, identifierbara kundposter.
Ändå gäller några praktiska skyddsräcken. Var tydlig mot kunder och intressenter med vad en syntetisk panel representerar: en kalibrerad statistisk modell av ett segment, inte en fokusgrupp av verkliga människor. Att överdriva panelens roll och kalla resultatet ”riktiga kundåsikter” ger en missvisande bild av metoden, även när prognoserna stämmer.
Se upp för bias inbyggd i träningsdata. En panel som kalibrerats på en smal eller snedfördelad datamängd kan i det tysta förstärka stereotyper om hur en demografisk grupp reagerar på bilder, särskilt när det gäller kön, ålder eller kulturell representation i produktfoton. Granska panelens sammansättning regelbundet, precis som du skulle kontrollera andra modeller för förändringar över tid.
Behåll slutligen syntetisk testning som ett första urvalssteg, inte en ersättning för samtycke och återkoppling från verkliga målgrupper där detta förväntas juridiskt eller etiskt, exempelvis i reglerade kategorier som hälso- eller finansannonsering.
Varför rangordningstänkande slår jakten på perfekta prognoser
De flesta team som är nya inom syntetisk testning vill ha en enda siffra: ”Den här bilden får 3,8 % CTR.” Instinkten är begriplig och nästan helt fel sätt att använda verktyget.
Det som faktiskt fungerar är att be panelen rangordna alternativen mot varandra och sedan behandla förstavalet som ditt bästa kort, inte ett garanterat utfall. Att granska koncept mot en kalibrerad panel före testning med människor minskar mätbart risken att lansera material som går emot varumärket eller tas emot dåligt. Den riskminskningen är det verkliga värdet här, inte perfekta prognoser.
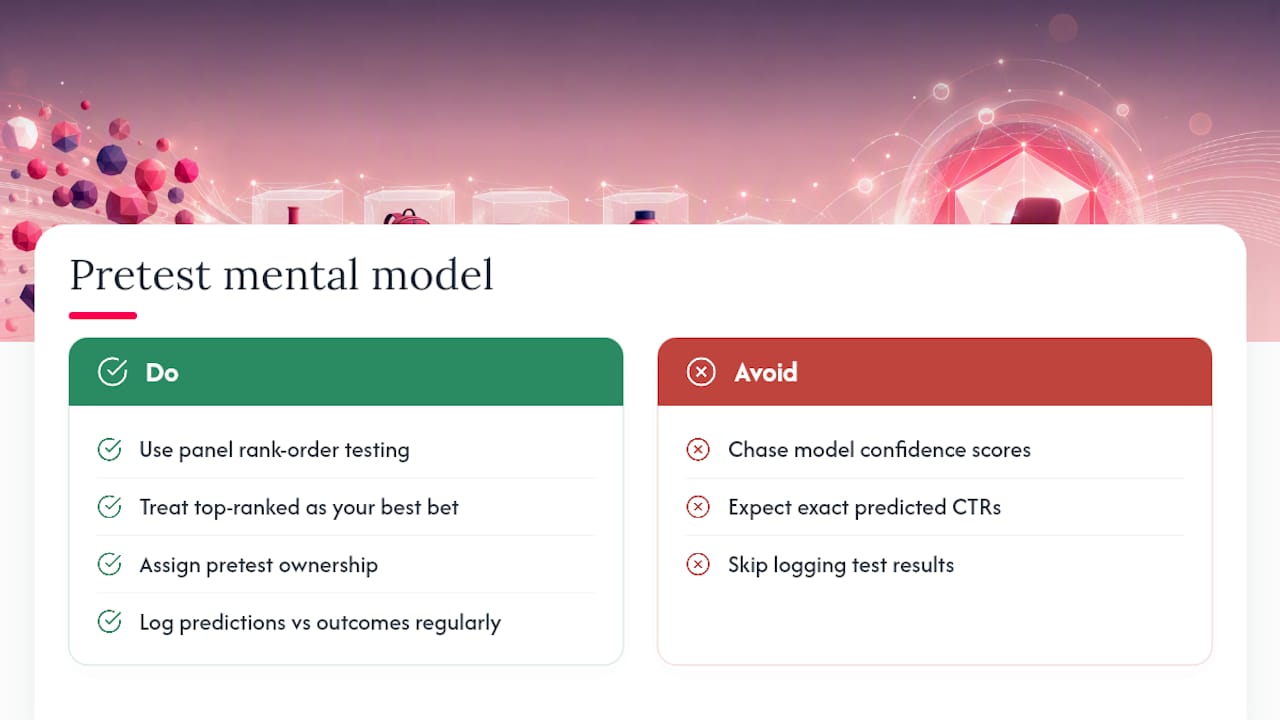
Jag har ständigt sett team vända på detta: de jagar modellens säkerhetspoäng i stället för dess rangordning och blir sedan frustrerade när det verkliga resultatet inte exakt matchar den förutsagda procentsatsen. Lösningen är inte en bättre modell utan ett bättre sätt att tänka. Behandla varje förtest som en välgrundad åsikt från en välinformerad panel, inte en kristallkula.
Den som ansvarar för produktionen av annonsmaterial, vare sig det är en ensam tillväxtmarknadsförare eller en särskild produktionsansvarig på en byrå, bör också äga förteststeget. Kör det med en fast rytm kopplad till lanseringskalendern och logga varje prognos mot verkliga resultat utan undantag. Den vanan ger växande värde. Sex månaders loggade avvikelser lär teamet mer om målgruppen än ett enskilt test någonsin kan göra.
Doruk
Testa produktbilderna innan du spenderar en dollar på medier
Det här arbetsflödet kan byggas in i en enda plattform som genererar bildvarianter, kör dem mot kalibrerade syntetiska köparpersonor och ger rangordnade prognoser för engagemang, klickfrekvens och konverteringsintention innan du spenderar annonsbudget på Meta, Google, TikTok eller Reddit.
- Generera varianter snabbt: skapa flera bildalternativ i linje med varumärket utan att vänta i en designkö.
- Poängsätt mot syntetiska personor: få psykografisk återkoppling som rangordnar alternativen i stället för att lämna dig att gissa.
- Validera innan du skalar upp: lansera den högst rankade varianten med en liten budget och jämför sedan prognosen med det verkliga resultatet.
Om du kör annonser med produktbilder med någon verklig budget alls bör du börja med en avgränsad pilot: ett mål, en kanal, ett målgruppssegment. Prova AI-annonsgeneratorn i nästa kampanj och se hur rangordningen står sig mot dina verkliga resultat.
Källor
Vanliga frågor
Vad är testning av produktbilder?
Det är processen att köra annonsbildsvarianter genom kalibrerade syntetiska köparpersonor för att få en rangordnad prognos över vilken som presterar bäst innan du spenderar riktig mediebudget.
Hur många bildvarianter bör jag testa samtidigt?
Testa flera varianter och ändra bara en variabel mellan dem, exempelvis bakgrunden, närvaron av ett ansikte eller textlagret.
Är testning med syntetiska personor lika träffsäker som testning med verkliga människor?
Välkalibrerade syntetiska paneler har i vissa studier rapporterat 85 till 95 procents samlad överensstämmelse med paneler av verkliga människor. Resultaten bör ändå behandlas som rangordnade hypoteser som behöver valideras i skarpt läge, inte som garantier.
Kan syntetisk testning helt ersätta skarpa A/B-tester?
Nej. Syntetisk testning fungerar bäst som ett första urvals- och rangordningssteg som begränsar alternativen. Du bekräftar fortfarande vinnaren med ett litet, kontrollerat test i skarpt läge.
Vilket verktyg hanterar både generering av annonsmaterial och förtestning?
POPJAM genererar annonsbildsvarianter i linje med varumärket och poängsätter dem mot syntetiska köparpersonor i ett och samma arbetsflöde, så att du inte behöver separata verktyg för material och validering.