

Förutsäg 33 % mer försäljning med kvantitativ annonstestning för marknadsförare
Praktiskt arbetsflöde för marknadsförare: kör kvantitativa annonstester med validerade STSL-poäng, bestäm rätt urvalsstorlek och använd plattformsexperiment för att välja...
Kvantitativ annonstestning använder kontrollerade experiment och mätningar med stora urval för att ta reda på vilket annonsmaterial som vinner innan du satsar verklig budget på det. Rätt utförd har den faktisk prognosförmåga: Kantars valideringsarbete med Link visade att annonser med höga poäng för Short-term Sales Likelihood vanligtvis genererar mer försäljning än genomsnittet, medan låga poäng ger mindre. Det är rätt första steg när du har två eller fler verkliga kandidater till annonsmaterial och tillräcklig budget för ett ordentligt splittest.
Kortversion:
- Kvantitativ annonstestning fungerar bäst när flera annonsvarianter jämförs tidigt i kampanjcykeln, särskilt före lansering eller uppskalning av mediebudgeten.
- De mest prediktiva metoderna är plattformarnas inbyggda experiment och beräkningar av urvalsstorlek som bygger på konverteringar, inte klick, för att säkerställa tillförlitliga resultat.
- Mått som validerade poäng för försäljningssannolikhet väger tyngre än skrytmått, och ett avgränsat konfidensintervall bekräftar verkliga resultatskillnader.
- En korrekt testdesign innebär att tydliga hypoteser, minsta upptäckbara effekter och fasta urvalsstorlekar bestäms före lansering för att undvika missvisande slutsatser.
- Att kombinera kvantitativa resultat med kvalitativ uppföljning hjälper till att förklara överraskande utfall och vägleder fortsatt utveckling av annonsmaterial.
Innehåll
- Vad kvantitativ annonstestning egentligen är till för
- Vilken kvantitativ metod ska du använda?
- Vilka mått visar faktiskt om en annons fungerar?
- Så utformar du ett test som faktiskt håller
- Tolka resultaten utan att lura dig själv
- Varför de flesta annonstester misslyckas och hur du löser det
- När du bör komplettera kvantitativa resultat med kvalitativ research
- En praktisk checklista värd att spara
- Så passar POPJAM in i testarbetsflödet
- Källor
- Vanliga frågor
Vad kvantitativ annonstestning egentligen är till för
Här är det ingen berättar när du sitter med tre annonsvarianter och en lanseringsdeadline: kvantitativ testning är inte ett verktyg, utan en kategori. Den omfattar validering av annonsmaterial före lansering, som om inledning A slår inledning B, jämförelser av format och placeringar, som Reels mot flöde eller stillbild mot video, och även avvägningar kring budgivning eller landningssidor när trafiken väl är igång.
Det den är bra på: att ge dig en siffra, inte en känsla. Det den är dålig på: att berätta varför en annons vann, vilket är där många team fastnar efter att datan kommit in.
Det starkaste argumentet för kvantitativa metoder är beläggen för deras prognosförmåga. Kantars forskning om validerade Link-poäng visade att annonser i den översta tredjedelen för STSL oftare såg ökad försäljning efter lansering än annonser i den nedersta tredjedelen. Det är ingen marginell fördel. Det är skillnaden mellan en slantsingling och en genomtänkt satsning.
Så passar kvantitativ testning in i kampanjens livscykel:
- Före lansering: jämföra annonskoncept innan några mediepengar spenderas
- Under kampanjen: experiment med format eller placeringar när ett koncept är bevisat
- Efter lansering: jämföra budstrategier och landningssidor för att få ut mer av en vinnare
Vilken kvantitativ metod ska du använda?
Alla testfrågor kräver inte samma upplägg. Fel metod slösar budget och ger, ännu värre, en falsk känsla av säkerhet. Så här skiljer sig de viktigaste metoderna:
- A/B- och splittestning. Två varianter, en variabel, delad trafik. Det är standardvalet för enkla frågor om ”slår X Y?” på skarpa plattformar.
- Monadisk testning. Varje respondent ser bara en annons i en enkätpanel och bedömer den isolerat. Använd detta när du vill få en ren bedömning av annonsens egen effekt utan jämförelseskevhet.
- Sekventiell monadisk testning. Respondenterna ser flera annonser efter varandra, men varje annons bedöms fortfarande som om den vore den enda som visats. Det är effektivare per respondent än ren monadisk testning, men ordningseffekter är en verklig risk som du måste kontrollera för.
- Plattformarnas inbyggda experiment. Google Ads Experiments och Meta Experiments delar upp trafiken i ömsesidigt uteslutande grupper. Det spelar roll eftersom manuella A/B-tester på samma plattform låter varianterna bjuda mot varandra i samma auktion, vilket driver upp CPC och förvanskar resultaten.
- Sekventiell testning, av SPRT-typ. Låter dig titta på resultat tidigt utan att bryta den statistiska giltigheten, men kräver ett större totalt urval och en förutbestämd stoppregel. Flexibiliteten köps alltså med större urvalsstorlek.
Enkätbaserade paneltester motiverar sin kostnad innan du har byggt fullständiga kampanjer, när du jämför koncept i stället för skarpa resultat. När annonsmaterialet är färdigt och budgeten börjar användas ger plattformsexperiment de verklighetssignaler som paneler inte kan ge.
Vilka mått visar faktiskt om en annons fungerar?
Alla mått väger inte lika tungt. Att behandla en snygg siffra som ett beslutsunderlag är ett sätt att stoppa bra annonsmaterial för tidigt. Tidiga indikatorer som visningar, CTR, andelen som slutar scrolla och uppmärksamhetspoäng visar om människor ens lägger märke till annonsen. Resultatmått som CVR, CPA, ROAS och validerade poäng för försäljningssannolikhet visar om uppmärksamheten faktiskt konverterar.
Gapet mellan dem betyder mer än vart och ett för sig. En annons som får många att sluta scrolla men har medelmåttig CVR har vanligtvis ett problem med inledningen som ser ut som ett målgruppsproblem.
| Typ av mått | Vad det mäter | När det är viktigast |
|---|---|---|
| CTR | Inledande intresse och inledningens styrka | Tidigt i tratten, formatstestning |
| Andel som slutar scrolla | Uppmärksamhet i flöden där mycket scrollas | Video och annonsmaterial för sociala medier |
| CVR | Konvertering efter klick | Testning av landningssidor och erbjudanden |
| CPA / ROAS | Konverteringarnas kostnadseffektivitet | Uppskalning och budgetbeslut |
| Poäng av STSL-typ | Validerad sannolikhet för ökad försäljning på kort sikt | Val av annonsmaterial före lansering |
Den sista raden har verklig tyngd. En annons med hög STSL korrelerar med 33 % högre försäljning än genomsnittet enligt Kantars Link-data. Därför tar fler team in validerad poängsättning av försäljningssannolikhet i checklistan före lansering i stället för att enbart lita på CTR. Om du vill ha en djupare genomgång av hur mått på annonsmaterialnivå hänger ihop med resultat går POPJAMs guide till analys av annonsmaterialets resultat igenom mekaniken.
Så utformar du ett test som faktiskt håller
De flesta dåliga testresultat beror inte på otur, utan på dålig design. Lås följande fyra saker innan du lanserar något:
- Bestäm din minsta upptäckbara effekt, MDE. Avgör vilken minsta förbättring som är värd att agera på. En ökning av CVR med 2 % kan spela roll för ett konto på 50 miljoner dollar och vara brus för ett på 5 000 dollar.
- Sikta på 80 % statistisk styrka och 95 % konfidens. Dessa värden är inte godtyckliga. De är branschens standardtrösklar som hindrar dig från att utse en vinnare som egentligen är en slumpträff.
- Beräkna urvalsstorleken utifrån konverteringar, inte klick. Låga konverteringsvolymer gör det nästan omöjligt att upptäcka en liten MDE utan en mycket större budget. För CPA-fokuserade tester bör du sikta på minst 100 konverteringar per variant som praktisk lägstanivå.
- Bestäm varaktighet och trafikfördelning före lansering, inte efteråt. En 50/50-fördelning ger snabbast ett tillförlitligt svar, men experiment mellan kampanjtyper, som Performance Max mot Shopping, behöver ofta 6 till 12 veckor för att passera plattformarnas inlärningsfaser och säsongsbrus.
Proffstips: Skriv hypotesen och slutdatumet i ett gemensamt dokument innan testet går live. Den enskilt största källan till dåliga beslut är inte matematik, utan team som halvvägs ändrar vad ”framgång” betyder.
Tolka resultaten utan att lura dig själv
Ett konfidensintervall anger det spann där ditt verkliga resultat sannolikt ligger, inte bara om du ”vann”. Om ditt 95-procentiga konfidensintervall för en CVR-ökning sträcker sig från -1 % till +8 % har du ännu ingen vinnare. Du har brus som ser lovande ut.
Statistisk signifikans och praktisk betydelse är inte samma sak. Ett test kan nå 95 % konfidens för en CVR-förbättring på 0,3 % som aldrig påverkar resultaträkningen. Kontrollera följande innan du utser en vinnare:
- Utesluter konfidensintervallet noll, med en meningsfull marginal?
- Är effektstorleken stor nog att spela roll vid din faktiska budget?
- Har testet körts genom en hel inlärningsfas på plattformen, så att tidig instabilitet inte snedvrider bedömningen?
- Jämför du resultaten med samma attribueringsfönster för alla varianter?
När du har en verklig vinnare skalar du upp gradvis i stället för att omfördela all budget över en natt. Plötsliga förändringar i utgifterna kan starta om kampanjens inlärningsfas och obemärkt sudda ut just den fördel du nyss bevisade.
Varför de flesta annonstester misslyckas och hur du löser det
Tre misstag står för de flesta ogiltiga resultat. Auktionsöverlappning ligger högst på listan: att köra två annonser som separata kampanjer på samma plattform låter dem bjuda mot varandra, vilket driver upp CPC och grumlar attribueringen. Lösningen är ett plattformsexperiment eller strikta målgruppsexkluderingar, inte en manuell uppdelning.
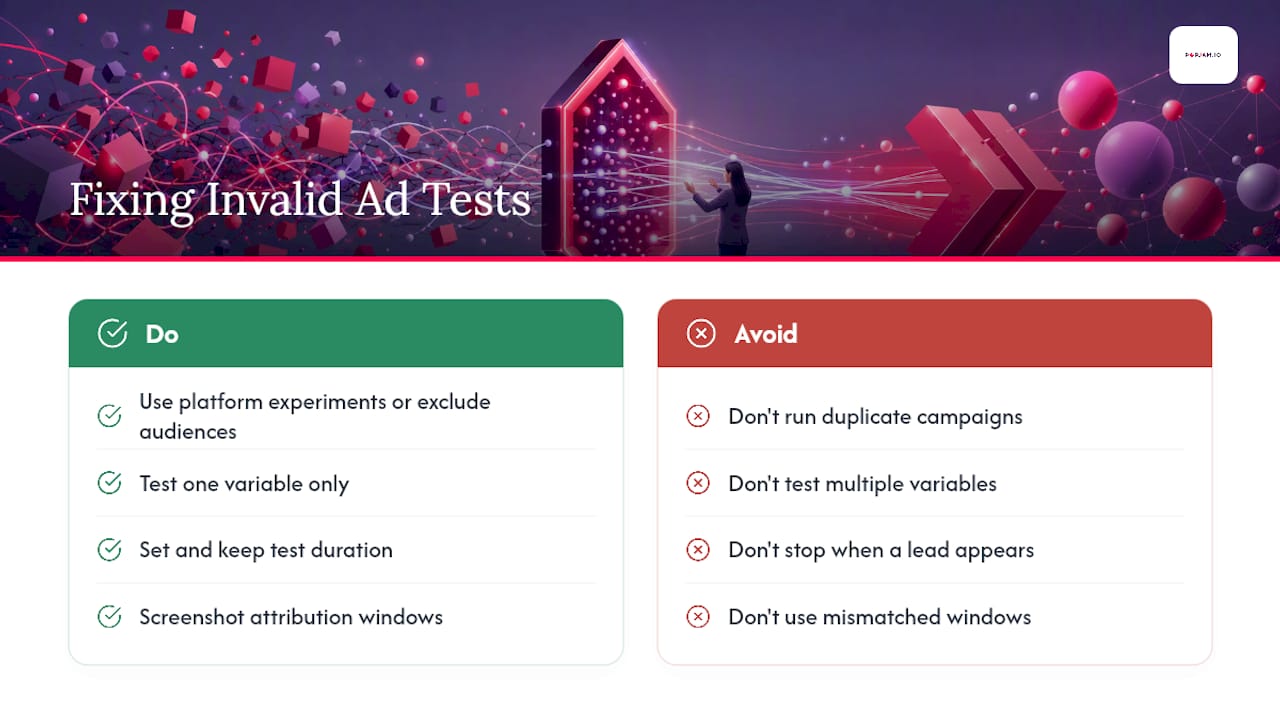
För det andra gör både testning av för många variabler samtidigt och stopp så fort en variant tar ledningen bedömningen ogiltig. Bestäm en variabel och en varaktighet före lansering.
För det tredje förstör attribueringsfönster jämförelser i det tysta. Om variant A får tillgodoräkna sig resultat inom ett klickfönster på 7 dagar och variant B inom ett visningsfönster på 1 dag jämför du inte prestation, utan inställningar.
Proffstips: Ta en skärmbild av attribueringsfönstrets inställningar för varje variant före lansering. Det tar tio sekunder och förebygger den vanligaste efteranalysen om ”varför det här testet ljög för oss”.
När du bör komplettera kvantitativa resultat med kvalitativ research
Ett kvantitativt test berättar vilken annons som vann. Det berättar sällan varför, och där fastnar många team efter ett ”lyckat” test utan något tydligt nästa steg.
Gör kvalitativ uppföljning när ett resultat överraskar dig eller när du behöver riktning inför nästa kreativa omgång, inte bara en resultattavla. Användbara upplägg är:
- Testning med gemensam visning i en sal, kombinerad med en uppföljande enkät som utforskar reaktionerna på det vinnande konceptet
- Kombinerade kvalitativa och kvantitativa upplägg där du intervjuar en del av de kvantitativa respondenter som gav annonsen högst eller lägst poäng
- Diagnostiska frågor som ”Vad fick dig nästan att sluta titta?” i stället för allmänna nöjdhetsbetyg
Resultaten från uppföljningen blir din nästa kvantitativa hypotes. Det är precis den återkopplingsloop som Ipsos beskriver i sitt arbete om att kombinera förtestmetoder.
En praktisk checklista värd att spara
Om du tar med dig en sak: välj en hypotes, beräkna urvalsstorleken före lansering, använd plattformsexperiment för att undvika auktionsöverlappning och utse ingen vinnare förrän konfidensintervallet ligger över noll med en marginal som spelar roll. Resten är detaljer.
Doruk
Så passar POPJAM in i testarbetsflödet
Om flaskhalsen är att över huvud taget producera tillräckligt många verkliga annonsvarianter att testa är det just den luckan POPJAM byggdes för att fylla. I stället för att vänta veckor på att ett designteam ska leverera tre varianter av en inledning genererar POPJAM annonsmaterial som följer varumärket och testar det mot syntetiska köparpersonas innan en enda dollar går till auktionen.
Det ger dig vägledning om vilka koncept som är värda att ta in i ett riktigt plattformsexperiment innan du lägger budget på att ta reda på det skarpt. Det ersätter inte den statistiska noggrannheten ovan, utan förser den med underlag: snabbare variantproduktion, tidigare signaler och färre bortkastade testplatser på idéer som aldrig skulle vinna. Om du bygger nästa omgång annonsmaterial för Meta, Google eller TikTok, prova AI-annonsgeneratorn och kör ditt första test med syntetiska personas före nästa lanseringsdatum.
Källor
- Kan annonstestning verkligen förutsäga försäljningseffekt? Kantars försäljningsvalidering av Link
- A/B-testning av betalda annonser: steg för steg med Google Ads och Meta (2026)
- Google Ads Experiments: så A/B-testar du | 2026
- A/B-testning av Facebook-annonser: statistisk guide från Wevion
Vanliga frågor
Vad innebär annonstestning?
Annonstestning innebär att systematiskt jämföra annonsvarianter genom kontrollerade experiment eller panelbaserade enkäter för att mäta vilken som presterar bättre på ett definierat mått före eller under en skarp kampanj.
Vilka är de viktigaste metoderna för kvantitativ annonstestning?
De centrala metoderna är A/B- och splittestning, monadisk testning, sekventiell monadisk testning, plattformarnas inbyggda experiment och sekventiell statistisk testning av SPRT-typ. De passar för olika steg i kampanjens livscykel.
Vad är skillnaden mellan kvalitativ och kvantitativ annonstestning?
Kvantitativ testning mäter numeriska utfall som CTR, CVR och validerad försäljningssannolikhet i stora urval. Kvalitativ testning samlar öppna reaktioner från mindre grupper för att förklara varför en annons presterar som den gör.
Hur mycket kostar det att testa annonser?
Kostnaden beror främst på den urvalsstorlek som din minsta upptäckbara effekt kräver. Att nå lägstanivån på minst 100 konverteringar per variant som rekommenderas för CPA-fokuserade tester kan kräva en betydande mediebudget innan resultaten blir tillförlitliga. Därför hjälper validering av annonskoncept med verktyg som POPJAM före lansering till att minska bortkastad testbudget.