

Fatta kreativa beslut på 48–72 timmar: GDPR-användartestning för marknadsförare
En praktisk handbok för marknadsförare om GDPR-säkra tester med syntetiska personas. Lär dig DPIA-stegen, integritetsjustering, återidentifieringsgranskningar och snabb...
Ja, du kan genomföra GDPR-kompatibel testning med syntetiska personas för att förtesta annonsmaterial. Det blir allt vanligare bland performance-team som vill ha signaler innan de spenderar. Tre kontroller gör metoden försvarbar: en anonymiseringsstandard som klarar Artikel 29-gruppens krav på identifierbarhet, en dokumenterad konsekvensbedömning avseende dataskydd där kvarstående risk finns och återkommande oberoende tester av återidentifiering. Plattformar som POPJAM.IO bygger in detta i arbetsflödet i stället för att behandla det som en eftertanke. För en detaljerad praktisk guide till GDPR-kompatibel AI för yrkesverksamma i Storbritannien, se denna resurs.
Kortversion:
- Fullständigt anonymiserade syntetiska data som inte kan kopplas tillbaka till individer kan falla utanför GDPR, men partiell eller svag anonymisering medför fortfarande skyldigheter enligt förordningen.
- Använd anonymiseringsstandarder, konsekvensbedömningar avseende dataskydd och oberoende återidentifieringstester regelbundet för att hålla tester med syntetiska personas förenliga med GDPR.
- När verkliga data används för att träna modeller behöver du säkerställa rättslig grund och uttryckligt samtycke om känsliga uppgifter används. Syntetiska utdata i sig kräver inget samtycke.
- Begränsa varje pilot till ett kampanjmål och ett målgruppssegment för att förebygga dataläckage och förenkla dokumentationen inför granskningar.
- Inför löpande återidentifieringsgranskningar och detaljerad dokumentation för att kunna försvara processen och undvika vanliga fallgropar i regelefterlevnaden.
Innehåll
- Vad innebär GDPR-användartestning för annonsmaterial?
- När gäller GDPR faktiskt för syntetiska utdata?
- Hur genomför du ett GDPR-säkert test med syntetiska personas?
- Differentiell integritet, k-anonymitet och återidentifieringsgranskningar förklarade
- Vilken dokumentation kräver GDPR för den här testningen?
- Behöver du samtycke för testning med syntetiska personas?
- Vilka misstag gör team kring regelefterlevnad för syntetiska personas?
- Därför är testning med syntetiska personas en del av det kreativa arbetet, inte bara regelefterlevnad
- Testa annonsmaterial innan du spenderar med POPJAM
- Källor
- Vanliga frågor
Vad innebär GDPR-användartestning för annonsmaterial?
När vi talar om GDPR-användartestning här menar vi något specifikt: att använda AI-genererade syntetiska personas och simulerade målgruppsreaktioner för att förtesta annonsmaterial innan det når en skarp kampanj. Det handlar inte om användbarhetsstudier med verkliga deltagare, skärminspelningar eller personuppgifter insamlade från faktiska användare. Det är en annan disciplin med andra regler.
Syntetiska personas speglar verkliga målgruppers statistiska mönster, beteendetendenser, köputlösare och reaktionsmönster utan att innehålla faktiska personidentifierare. Syntetiska datamängder kan byggas utifrån CRM-exporter, engagemangshändelser och historiska kampanjdata för att simulera hur ett segment kan reagera på en rubrik, en bild eller en uppmaning till handling.
Därför satsar team på metoden:
- Snabbare iterationscykler: du får vägledande återkoppling på timmar i stället för veckor av skarpa tester
- Ingen exponering av verkliga användardata för externa kreativa leverantörer eller byråpartner
- Lägre annonsutgifter före lansering eftersom svagt annonsmaterial sållas bort innan det förbrukar budget
När gäller GDPR faktiskt för syntetiska utdata?
Det är här de flesta team snubblar. GDPR:s skäl 26 och artikel 4.5 drar en tydlig gräns: om data verkligen och oåterkalleligt är anonymiserade faller de utanför GDPR:s tillämpningsområde. Om de direkt eller indirekt kan kopplas tillbaka till en identifierbar person är de fortfarande personuppgifter, och alla GDPR-skyldigheter gäller.
Det knepiga är att ”ser syntetiskt ut” och ”är anonymt” inte är samma sak. Artikel 29-gruppens kriterier för identifierbarhet bedömer om en registrerad person realistiskt skulle kunna särskiljas, kopplas samman eller bli föremål för härledningar, även genom utdata som verkar helt fabricerade. En syntetisk persona som bygger för nära på ett litet, särpräglat kundsegment kan fortfarande vara återidentifierbar om tillräckligt många korrelerade attribut läcker igenom.
Fullständigt anonymiserade syntetiska data kan ligga helt utanför GDPR. Delvis syntetiska eller svagt anonymiserade utdata förblir vanligtvis personuppgifter, vilket utlöser alla krav på regelefterlevnad.
När utdata fortfarande klassas som personuppgifter ansvarar du för:
- En dokumenterad rättslig grund för den ursprungliga behandling som skapade den syntetiska modellen
- En konsekvensbedömning avseende dataskydd, DPIA, innan genereringen börjar, inte efteråt
- Registrerades rättigheter till tillgång, radering och invändning, kopplade tillbaka till källdata
- Uttryckligt samtycke eller ett annat villkor enligt artikel 9 om särskilda kategorier av personuppgifter användes för att träna modellen
Hur genomför du ett GDPR-säkert test med syntetiska personas?
Här är arbetsflödet som håller för granskning, från planering till validering.
- Planera testet. Definiera kampanjmålet, hypotesen, alltså vilken kreativ riktning du tror vinner och varför, omfattningen av de personas som ingår och din rättsliga grund om verkliga data matar modellen. Koppla in dataskyddsombudet tidigt om det finns oklarheter kring identifierbarhet.
- Hantera data korrekt. Använd helt syntetiska personas när det är möjligt. Om modellen delvis bygger på verkliga kunddata dokumenterar du källans rättsliga grund och tillämpar uppgiftsminimering. Ta bort allt som testet inte faktiskt behöver.
- Generera med integritetsparametrarna inställda. Tillämpa differentiell integritet eller motsvarande bruskalibrering före generering. Håll undan en valideringsmängd så att dina syntetiska personas inte överanpassas till ett smalt utsnitt av tidigare beteende.
- Kör simuleringen. Rangordna kreativa riktningar mot varandra i stället för att jaga absoluta poäng. Behandla varje resultat som vägledning, inte som en absolut sanning, och håll testet konfidentiellt tills du har agerat på resultaten.
- Validera oberoende. Beställ återidentifieringstester av datamängden. Pilotkör det vinnande annonsmaterialet med en liten skarp budget före full utrullning och logga antaganden, parametrar och resultat för granskningsspåret.
Proffstips: Börja varje pilot med ett kampanjmål och ett målgruppssegment. Om du försöker validera tre kreativa riktningar i fem segment redan i första körningen begraver du signalen du faktiskt behöver och gör dokumentationen svår att försvara senare.
Team som använder den här typen av strukturerad metod har rapporterat kreativa beslut inom 48 till 72 timmar utan att exponera tidiga koncept offentligt. Det är en betydande fördel när en konkurrent skulle kunna ta en skärmbild av ett skarpt test.
Differentiell integritet, k-anonymitet och återidentifieringsgranskningar förklarade
Integritetsskyddande tekniker är inga valfria tillägg. Det är de som gör en syntetisk datamängd försvarbar. Två tekniker gör merparten av arbetet.
Differentiell integritet tillför kalibrerat statistiskt brus till en datamängd så att ingen enskild post kan återskapas bakvägen, samtidigt som de samlade mönstren förblir användbara för analys. Avvägningen är verklig: mer brus innebär lägre återidentifieringsrisk men sämre statistisk trohet. Team behöver därför justera brusnivåerna iterativt tills datan fortfarande stödjer testuppgiften utan att exponera individer.
K-anonymitet fungerar annorlunda: poster grupperas så att varje individ inte går att skilja från minst k-1 andra som delar samma attribut. Den vanliga fallgropen är att behandla k-anonymitet som en engångsruta att bocka av. Attributens korrelationer ändras när nya datakällor läggs till, och en datamängd som var k-anonym förra kvartalet kanske inte är det idag.
Återidentifiering är ett rörligt mål, inte en granskning som görs en gång för alla. Den första granskningen bör behandlas som en baslinje, med återkommande omtester där metoden dokumenteras varje gång så att granskningsspåret håller om en tillsynsmyndighet senare ställer frågor.
Begär följande innan du litar på en leverantörs motor för syntetiska personas:
- De specifika integritetsparametrar som används, som brusnivåer och trösklar för k-värden
- Oberoende granskningsrapporter, inte bara interna självbedömningar
- Underlag från återidentifieringstester med datum och metodik
- Dokumentation om hur ofta granskningarna uppdateras
Vilken dokumentation kräver GDPR för den här testningen?
Styrning skiljer ett testprogram som går att försvara från ett som faller samman så fort juridikavdelningen ställer en fråga. En rekommenderad operativ struktur omfattar en DPIA, integritetsskyddande tekniker, löpande övervakning av återidentifiering och dokumenterade register över behandling.
Gör en DPIA när syntetisk generering använder verkliga personuppgifter, särskilt i stor skala eller med känsliga attribut, och låt den omfatta datakällan, anonymiseringsmetoden och kvarstående risk. Enligt artikel 30 bör registren över behandling ange rättslig grund, tillämpade skyddsåtgärder, lagringstider och raderingspolicyer för både källdata och syntetiska utdata.
Fördela tydliga roller innan testningen börjar:
- Dataskyddsombud: granskar DPIA:ns omfattning och risken för identifierbarhet
- Juridik: bekräftar rättslig grund och samtyckesstatus
- Teknik: implementerar integritetsparametrar och underhåller granskningsloggar
- Marknadsföring: godkänner testets omfattning och hanteringen av konfidentialitet
Bestäm vad som ska utlösa en granskning, exempelvis en ny datakälla, omträning av modellen eller en schemalagd kvartalskontroll, och definiera en incidentprocess för vad som händer om en återidentifieringsgranskning upptäcker ett problem.
Behöver du samtycke för testning med syntetiska personas?
Här är nyansen som många missar: syntetiska personas behöver inte själva samtycke eftersom de inte är verkliga människor. Men så fort verkliga personuppgifter används för att bygga eller träna modellen bakom dem styr samtycke, eller en annan giltig rättslig grund, dessa indata, inte de syntetiska utdata som skapas.
Om du bygger personas från CRM-exporter, tidigare kampanjrespondenter eller engagemangshändelser behövde den ursprungliga datainsamlingen ha sin egen rättsliga grund när uppgifterna samlades in. En vanlig brist är att i efterhand besluta att använda datan för träning av syntetiska modeller utan att kontrollera om det ursprungliga samtycket eller grunden berättigat intresse omfattar det.
Praktisk samtyckeshantering för arbetsflödet innebär att:
- Granska om det ursprungliga samtycket till datainsamling omfattar ”modellträning för teständamål”, inte bara ”kampanjpersonalisering”
- Hålla den syntetiska genereringsprocessen åtskild från kundernas samtyckesändringar, så att ett återkallat samtycke utlöser borttagning av kundens data från framtida modellträningskörningar
- Dokumentera samtyckeskedjan från källdata via modell till syntetiska utdata, trots att den slutliga personan i sig inte innehåller personuppgifter
Om dina syntetiska personas helt bygger på licensierade tredjepartspaneler eller fullständigt aggregerade branschdata utan direkt kundunderlag minskar samtyckesbördan avsevärt, men du behöver fortfarande kontrollera leverantörens egen regelefterlevnad.
Vilka misstag gör team kring regelefterlevnad för syntetiska personas?
Det vanligaste felet är att förväxla ”ser anonymt ut” med ”är anonymt”. En personagenerator som skapar trovärdiga, fiktivt klingande namn och beteenden kan fortfarande bygga på en datamängd som är så liten att individer går att återidentifiera. Det gäller särskilt nischade B2B-segment där några få firmografiska attribut kan peka ut ett verkligt företag.
Ett andra misstag är att behandla DPIA:n som en engångsinsats för regelefterlevnad i stället för ett levande dokument. Team gör en DPIA vid lansering och fortsätter sedan att lägga till nya datakällor i träningsmängden under det följande året utan att någonsin återvända till den.
Andra återkommande fallgropar:
- Att hoppa över återidentifieringsgranskningar efter att leverantören först tagits in, med antagandet att det första testet skyddar dig på obestämd tid
- Att inte dokumentera varför en datamängd bedömdes vara tillräckligt anonymiserad, så att det saknas ett försvarbart dokumentationsspår om bedömningen ifrågasätts
- Att dela ”anonymiserade” syntetiska utdata med byråpartner eller konsulter utan att kontrollera om det fortfarande finns återidentifieringsrisk
- Att använda så aggressiva brusnivåer för differentiell integritet att de syntetiska personorna ger oanvändbara kreativa signaler och därmed omintetgör själva syftet med testningen
- Att anta att en plattforms marknadsföringspåstående om ”GDPR-kompatibilitet” ersätter din egen DPIA och ditt granskningsspår
Lösningen på de flesta av dessa problem handlar om rutiner, inte teknik: bygg in återkommande granskningar och dokumentationskontroller i kalendern på samma sätt som en säkerhetsgranskning, i stället för att behandla dem som en engångsuppgift vid uppsättningen.
Därför är testning med syntetiska personas en del av det kreativa arbetet, inte bara regelefterlevnad
Det mesta innehållet om regelefterlevnad behandlar syntetiska data som en juridisk omväg, något man accepterar för att undvika risk. Den bilden underskattar möjligheterna. Integritetsspecialister inom marknadsföring ser allt oftare syntetiska personas som en konkurrensfördel i det kreativa arbetet. När tillgången till förstapartsdata begränsas på annonsplattformarna får team som kan simulera beteenderespons utan att vara beroende av verkliga målgruppsdata en varaktig fördel.
POPJAM.IO gör detta genom att skapa annonsmaterial som följer varumärket och testa det mot syntetiska köparpersonas byggda från psykografiska profiler. Det ger marknadsteam återkoppling innan en enda dollar går till Meta, Google eller TikTok. Det är beviset att ta till sig: arbetsflödet ovan är inte teoretiskt, utan finns redan i drift på plattformsnivå. För team som vill fördjupa sig i metodiken går POPJAMs guide till syntetisk användartestning för performance-team igenom hur det fungerar mer i detalj.
Om du utformar din första pilot, håll den smal: ett kampanjmål, tre kreativa riktningar, ett valideringsfönster på en till två veckor och ett tydligt mått, som förutsagd engagemangsrangordning, sentimentfördelning eller klickavsikt, som du sedan jämför med skarpa resultat.
Doruk
Testa annonsmaterial innan du spenderar med POPJAM
POPJAM är alternativet till att bränna annonsbudget på gissningar. Du skapar annonsmaterial som följer varumärket och testar det mot syntetiska köparpersonas innan något går live, så att svaga koncept sållas bort på timmar i stället för efter en misslyckad kampanj.
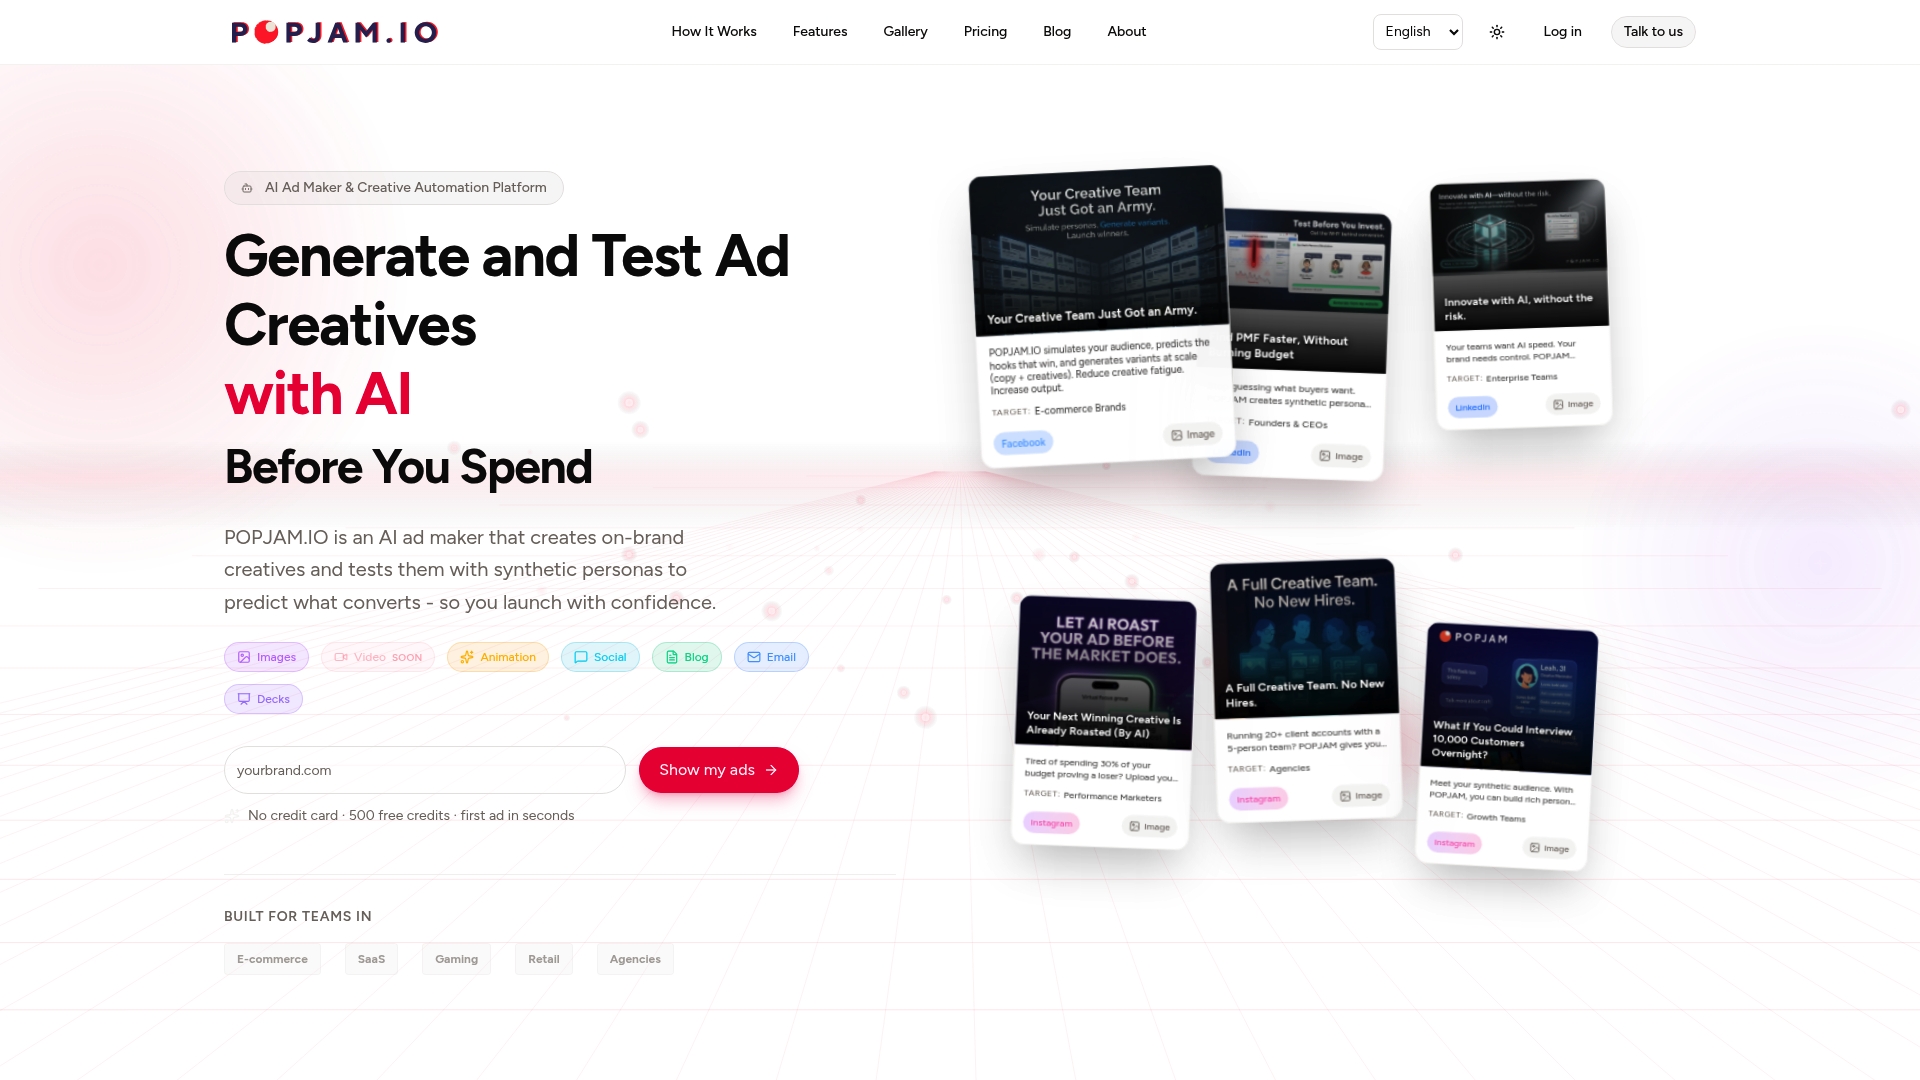
Plattformen bygger in integritetsskydd direkt i personasimuleringen. Det kreativa teamet får därför psykografisk återkoppling utan det manuella arbetet med att från grunden bygga en anonymiseringsprocess för regelefterlevnad. Oavsett om du sållar Google Display-koncept eller förbereder en full lansering i flera kanaler på Meta, TikTok och LinkedIn är arbetsflödet detsamma: generera, simulera, förfina och spendera sedan.
Byråer som hanterar flera kundkonton kan se hur detta skalas upp på sidan om AI-annonsgeneratorn för byråer. Om du är redo att se hur återkoppling från syntetiska personas förändrar processen före lansering, börja med en provperiod och gör din första jämförelse av annonsmaterial den här veckan.
Källor
- Syntetiska data under GDPR: utmaningar med regelefterlevnad | GDPR Local
- Använd syntetiska målgrupper för att testa annonsmaterial utan att riskera budgeten | Sotavento Medios
Vanliga frågor
Är GDPR-kompatibel testning med syntetiska personas verkligen möjlig?
Ja. Det kräver en anonymiseringsstandard som uppfyller Artikel 29-gruppens kriterier för identifierbarhet, en DPIA där risk finns och återkommande oberoende tester av återidentifiering.
Gäller GDPR för helt syntetiska annonstestdata?
Inte alltid. Fullständigt anonymiserade syntetiska data kan falla utanför GDPR:s tillämpningsområde, men delvis syntetiska eller svagt anonymiserade utdata förblir vanligtvis personuppgifter som omfattas av alla skyldigheter.
Behöver jag samtycke för att bygga syntetiska personas?
Den syntetiska personan behöver inte själv samtycke, men verkliga data som används för att träna den underliggande modellen behöver en giltig rättslig grund. Särskilda kategorier av personuppgifter kräver uttryckligt samtycke eller ett annat villkor enligt artikel 9.
Hur ofta bör återidentifieringsgranskningar göras?
Behandla återidentifieringsrisk som något löpande, inte en engångskontroll. Schemalägg återkommande granskningar, särskilt efter att nya datakällor lagts till eller en personamodell tränats om, och dokumentera metoden varje gång.
Kan plattformar som POPJAM hjälpa till med GDPR-säker testning av annonsmaterial?
Ja. POPJAM skapar annonsmaterial och testar det mot syntetiska köparpersonas byggda från psykografiska profiler. Det ger team vägledande återkoppling innan en kampanj går live utan att exponera verkliga användardata.
Vilket är teamens största misstag kring regelefterlevnad?
Att anta att data som ser syntetiska ut automatiskt är anonyma. En personagenerator kan skapa utdata som verkar fiktiva men ändå är återidentifierbara om de bygger på en liten eller särpräglad underliggande datamängd.