Dynamisk optimering av annonsmaterial för prestationsmarknadsförare
Ta vara på kraften i dynamisk optimering av annonsmaterial. Använd AI för att generera vinnande annonser och få ut maximalt av budgeten med detta innovativa arbetsflöde för marknadsföring.
Snabbversion:
- Dynamisk optimering av annonsmaterial omfattar AI-driven generering av material före lansering, filtrering med syntetiska personor och adaptiva experiment. Det hjälper prestationsmarknadsförare och byråer att snabbare hitta toppmaterial och minskar bortkastade visningar. Fälttester visar betydande engagemangsökningar bland de bästa resultaten, vilket bekräftar arbetsflödets effektivitet när det genomförs korrekt.
Dynamisk optimering av annonsmaterial, så som begreppet används i den här artikeln, innebär AI-driven generering, simulering och validering av annonsmaterial före lansering med syntetiska köparpersonor och adaptiva experiment. Det är ett arbetsflöde i två steg, från offline till online: först skapar en generativ modell kandidater med vägledning av en prognosbaserad rangordningsmodell som tränats på dina historiska A/B-data. Sedan väljer ett adaptivt experiment som körs i omgångar vinnare i verklig trafik. Om du kör betalda kampanjer på Meta, Google, TikTok eller LinkedIn och vill sluta slösa budget på otestat material är det här arbetsflödet för dig.
Innehåll
- Vad betyder dynamisk optimering av annonsmaterial egentligen här?
- Varför ett arbetsflöde från offline till online förändrar resultaten
- Vilka mätvärden och experimentparametrar bör du ange?
- Vilka data och vilken infrastruktur behöver du?
- Hur passar syntetiska personor in i DCO-processen?
- God praxis och vanliga misstag vid genomförande av DCO
- Vad visar fältexperimenten egentligen?
- Så utvärderar du DCO-leverantörer och vilka frågor du bör ställa
- Viktigaste slutsatserna
- Varför det här behöver göras noggrant
- POPJAM gör arbetsflödet tillgängligt från dag ett
- Användbara källor
- Vanliga frågor
Vad betyder dynamisk optimering av annonsmaterial egentligen här?
På större delen av webben definieras DCO som sammansättning av mallar i realtid när annonser visas. Det är en annan produkt för ett annat team. Den här artikeln handlar om något mer användbart för prestationsmarknadsförare och tillväxtteam: AI-generering plus förtester med syntetiska personor plus adaptiva onlineexperiment.
Vad denna DCO omfattar:
- AI-generering av annonsvarianter i linje med varumärket utifrån grundmaterial
- Simulering med syntetiska personor för att filtrera bort förlorare innan pengar spenderas
- Adaptiva experiment i omgångar som omfördelar trafik mot vinnare
Vad den inte omfattar:
- Personalisering av mallar i realtid på annonsservern
- Dynamiska produktflöden eller pixelsammansättning efter målgruppssegment
De två stegen kompletterar varandra. Att generera kandidatuppsättningar offline är snabbt och billigt. Adaptivt urval online är långsammare men gör prognoser till verifierade vinnare. Team som kör fler än en handfull kampanjer varje månad, eller byråer som hanterar flera kunder, har störst nytta av detta jämfört med ett enkelt A/B-test med två varianter.
Varför ett arbetsflöde från offline till online förändrar resultaten
Kärnvärdet är enkelt: du hittar de bästa vinnarna snabbare och slösar färre visningar på uppenbara förlorare. Fältexperiment med detta arbetsflöde registrerade engagemangsökningar på 45,1 %, 46,7 % och 36,2 % i tre separata tillämpningar. Det är inga genomsnittliga ökningar för allt material. Det är vinsterna av att hitta det bästa materialet i en uppsättning i stället för att köra en enda otestad annons.
En prognosbaserad rangordningsmodell räcker inte ensam. Offlinepoäng är brusiga ställföreträdare för verkliga resultat. Modellens verkliga uppgift är att öka kandidaturvalets täckning, alltså att få med fler riktigt starka material i testuppsättningen. Det adaptiva experimentet gör sedan det faktiska urvalet under verkliga trafikförhållanden. Att hoppa över onlinesteget och direkt lansera det högst rankade offlinematerialet är ett av de vanligaste och dyraste misstagen team gör.
De bäst presterande varumärkena testar 3–5 nya materialvarianter varje vecka och gör testningen till en kontinuerlig drivkraft i stället för en kvartalshändelse. Den rytmen är bara möjlig när generering och förfiltrering automatiseras.
Vilka mätvärden och experimentparametrar bör du ange?
Mätvärden som spelar roll
| Mätvärde | Vad det mäter | Prioritet |
|---|---|---|
| Kandidaturvalets täckning | Andel av det verkliga toppmaterialet som fångas i uppsättningen | Offline |
| Den valda testarmens kvalitet | Experimentvinnarens resultat i verklig trafik | Online |
| Regret, förlust under testningen | Visningar som läggs på sämre testarmar under testet | Online |
| CTR / andel stoppat skrollande | Engagemangssignal; brusig i korta tidsfönster | Sekundär |
| CPA / ROAS | Konverteringseffektivitet; primärt beslutsmått | Primär |
Använd CPA eller ROAS som stoppkriterium i optimeringen. CTR är en användbar tidig signal, men briefens kvalitet och anpassning till kundlivstidsvärde driver konverteringseffekt mer tillförlitligt än enbart klickfrekvens.
Vägledning för experimentstorlek
| Uppsättningens storlek (K) | Rekommenderad första omgång | Minsta antal visningar per testarm |
|---|---|---|
| 8 | 5,- totalt | - |
| 12 | 9,- totalt | - |
Detta är utgångspunkter. Brusiga engagemangsmått på kort sikt kan leda tidig omfördelning fel, så behåll jämn fördelning under minst en hel omgång innan posteriorfördelningarna uppdateras.
Vilka data och vilken infrastruktur behöver du?
För att köra arbetsflödet i stor skala krävs fyra konkreta underlag innan du börjar.
| Datatyp | Vad du behöver | Varför det spelar roll |
|---|---|---|
| Historiska experiment | Resultat från randomiserade A/B-tester med material-ID:n | Tränar den prognosbaserade rangordningsmodellen |
| Signaler på händelsenivå | Rader för visningar, klick och konverteringar med tidsstämplar | Förser posterioruppdateringar i adaptiva tester med data |
| Metadata för annonsmaterial | Text, visuella beskrivningar, format och placering | Möjliggör borttagning av dubbletter och varumärkesfiltrering |
| Kohortidentifierare | Experiment-ID, exponeringsfönster och attribueringsfönster | Säkerställer ren träning av rangordningsmodellen och resultatloggning |
På modellsidan behöver du en prognosbaserad rangordningsmodell, exempelvis en gradientförstärkt rangordningsmodell eller en finjusterad inbäddningsmodell, en fryst generativ modell med ett API för instruktioner, en experimentkörmiljö som stödjer omfördelning i omgångar och en loggningsinfrastruktur för observerbarhet.
Om integritet: träna rangordningsmodellen enbart på aggregerade signaler med samtycke. Skicka aldrig personliga identifierare till materialmetadata eller experimentloggar. Använd utfall på kohortnivå och anonymiserade händelsedata. GDPR-enlig aggregering är inte valfri om någon del av trafiken omfattar EU-användare, och den är god praxis oavsett.
Hur passar syntetiska personor in i DCO-processen?
Syntetiska personor fungerar som ett snabbt förfilter. Innan du spenderar en dollar på riktig trafik kör du kandidatuppsättningen genom kalibrerade AI-personor som simulerar hur specifika köparsegment skulle reagera på varje material. Målet är att sålla bort uppenbara förlorare, inte att ersätta skarp testning.
Dokumenterade fallstudier rapporterar betydande ökningar av ROAS, CVR och CTR när syntetiska förtester kombineras med validering i skarpt läge. Nyckelordet är ”kombineras”. Syntetiska paneler förutsäger relativa rangordningar väl. De är mindre tillförlitliga när det gäller absoluta resultatsiffror.
När du bör köra syntetiska förtester:
- Koncepturval bland fem eller fler budskapsvinklar
- Kontroller av kulturell känslighet före inträde på en ny marknad
- Validering av inledande budskap för specifika segment, exempelvis priskänsliga respektive funktionsmotiverade köpare
- Rangordning av rubriker när textvarianterna är fler än vad budgeten för skarpa tester räcker till
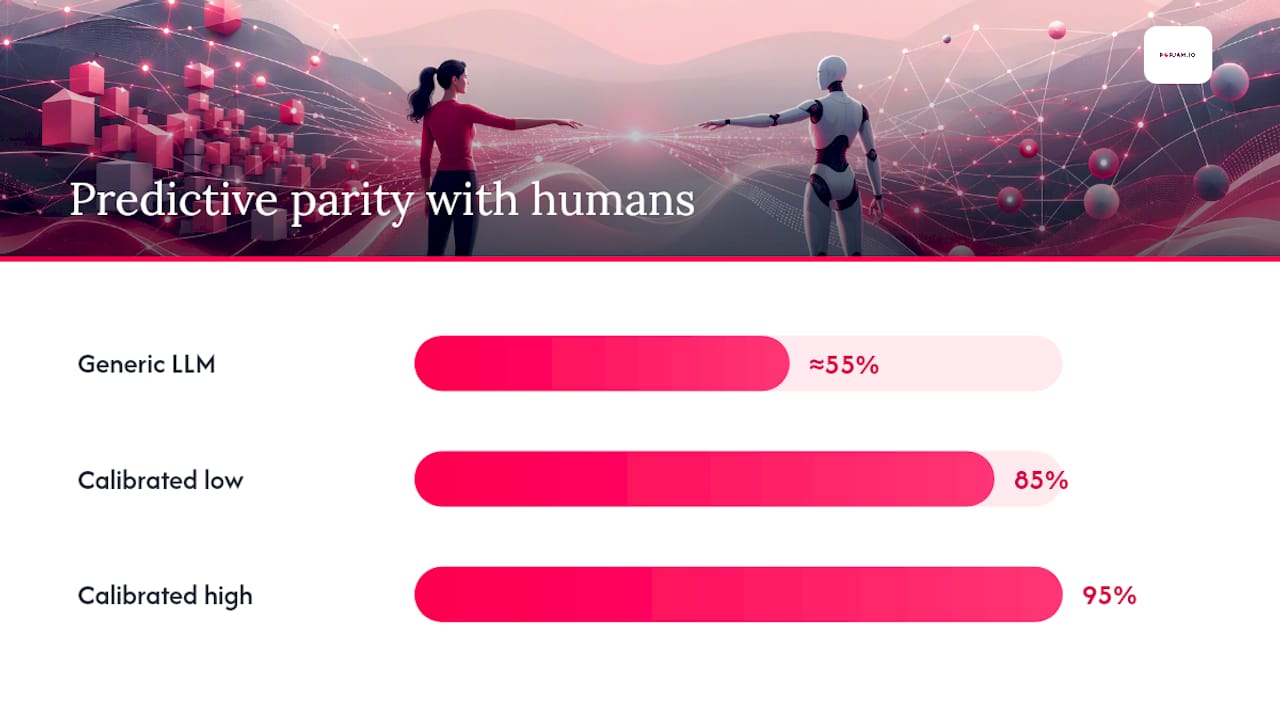
Kalibrering är avgörande. Generiska instruktioner till stora språkmodeller ger ungefär 55 % prognosmässig överensstämmelse med paneler av verkliga människor. Kalibrerade syntetiska personor förankrade i verkliga psykografiska konsumentdata når 85–95 % överensstämmelse. Skillnaden är om personorna speglar verkligt köpbeteende eller ett statistiskt genomsnitt av internettext.
Behåll en valideringsomgång med människor för material där mycket står på spel, varumärkeslanseringar eller känsliga kategorier. Syntetiska paneler är ett verktyg för snabbhet, ingen ersättning för omdöme.
För en praktisk genomgång av hur du bygger och använder personorna är POPJAMs guide om vad syntetiska personor är en bra startpunkt.
God praxis och vanliga misstag vid genomförande av DCO
Gör detta:
- Isolera en variabel per genereringsomgång så att rangordningsmodellen lär sig rena signaler
- Lås varumärkeselement som logotypplacering, färgpalett och typsnitt före genereringen
- Bestäm stoppregler i förväg innan något adaptivt experiment startar
- Versionshantera varje material med ett unikt ID kopplat till genereringsinstruktionen och rangordningspoängen
- Låt en människa granska varumärkessäkerheten innan något material ingår i den skarpa uppsättningen
Undvik detta:
- Att optimera enbart för klick; CTR-vinnare presterar ofta sämre på CPA
- Att lansera det högst rankade offlinematerialet utan validering i skarpt läge
- Att köra större uppsättningar än trafiken kan ge besked om inom rimlig tid
- Att hoppa över borttagning av dubbletter; nästan identiska testarmar späder ut signalen och ökar förlusten under testningen
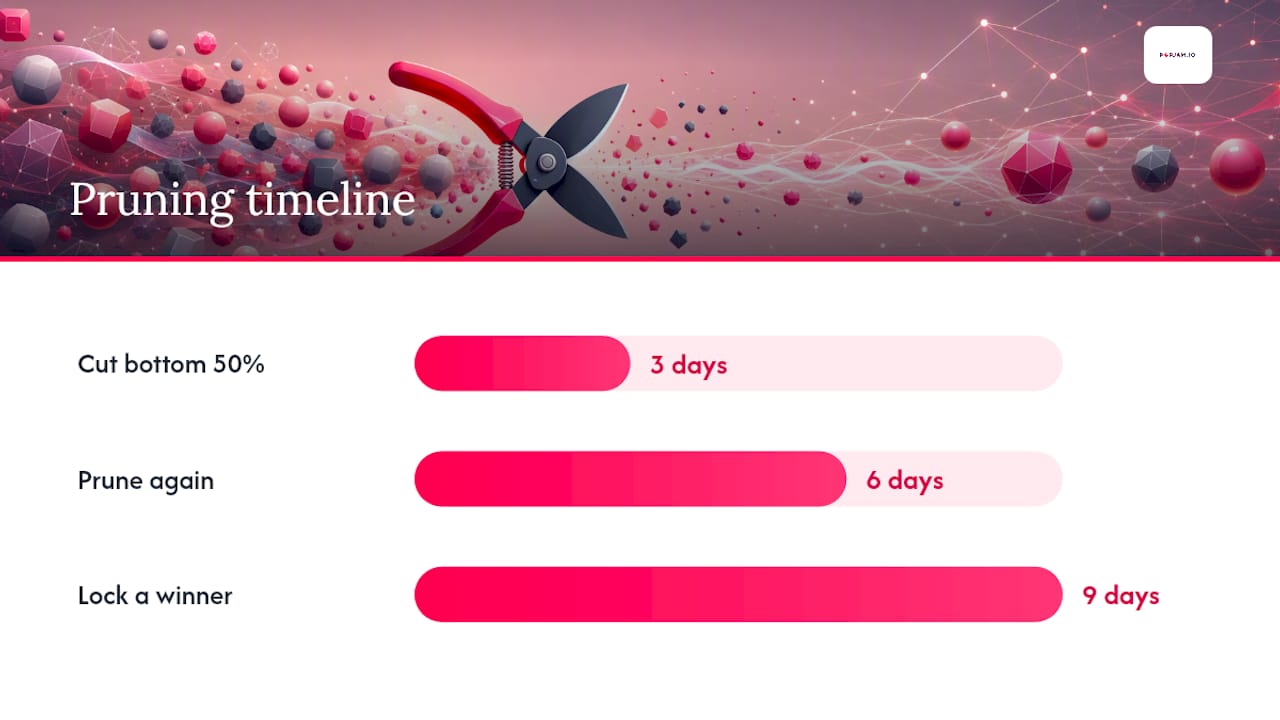
Proffstips: Kombinera testning av annonsmaterial med varianter av landningssidor. Ett vinnande annonsmaterial som driver trafik till en felmatchad landningssida tappar större delen av sitt lyft. Gallringsregeln 3-3-3, ta bort den sämsta hälften efter tre dagar, gallra igen dag sex och lås en vinnare senast dag nio, fungerar bra när du tillämpar den på hela tratten och inte bara annonsenheten.
Styrning är lika viktig som metodik. Bygg in en granskningskö i arbetsflödet så att inget AI-genererat material går live utan en människas godkännande. Det gäller särskilt reglerade kategorier och varumärkeskänsliga kampanjer.
Vad visar fältexperimenten egentligen?
Det mest trovärdiga underlaget kommer från forskningen om arbetsflödet från offline till online, som dokumenterade tre separata tillämpningar i fält.
| Experiment | Rapporterat lyft | Validerad del av arbetsflödet |
|---|---|---|
| Tillämpning 1 | +45,1 % engagemang | Generering styrd av rangordningsmodell + adaptivt urval |
| Tillämpning 2 | +46,7 % engagemang | Återkommande kritik vid inferens |
| Tillämpning 3 | +36,2 % engagemang | Adaptiv omfördelning i omgångar |
Detta är lyft bland de bästa resultaten, alltså vinsten av att hitta det bästa materialet i uppsättningen jämfört med en basnivå. Tolka dem som taket för vad arbetsflödet kan ge när datakvaliteten är hög och rangordningsmodellen välkalibrerad. Ditt faktiska lyft beror på mängden historiska data, modellens träffsäkerhet och uppsättningens kvalitet.
Reproducerbarhet kräver tre saker: randomiserade historiska experiment, inte observationsdata, loggning på händelsenivå med ren attribuering och en process för att bilda uppsättningar som inte läcker testutfall till träningen. Team som hoppar över något av dessa tre steg får sämre rangordningsprestanda och brusigare experimentresultat.
Så utvärderar du DCO-leverantörer och vilka frågor du bör ställa
När du bedömer en plattform för det här arbetsflödet bör du ställa dessa frågor direkt.
- Kan jag importera historiska A/B-experimentresultat för att träna rangordningsmodellen?
- Hur ofta tränas modellen om, och kan jag starta omträning manuellt?
- Har generatorn kontroller för att låsa och redigera varumärkeselement?
- Vilka adaptiva experimentupplägg stödjer plattformen, exempelvis Thompson sampling, UCB eller bayesianska metoder?
- Kan experimentloggar exporteras för extern analys?
- Hur hanterar plattformen integritetsefterlevnad för träningsdata?
- Vilken minsta mängd historiska experiment behövs för en tillförlitlig rangordningsmodell?
Vad POPJAM levererar utifrån dessa kriterier:
POPJAMs plattform för automatisering av annonsmaterial omfattar AI-generering, simulering med syntetiska personor och testning före lansering i ett enda integrerat arbetsflöde. Den stödjer bilder, video, animation, inlägg i sociala medier och e-post för Meta, Google, TikTok, LinkedIn och Reddit. Experimentdata går direkt in i utformningen av briefen, vilket hanterar den kvalitetslucka i briefen som fristående generatorer lämnar öppen. POPJAM är utformat för GDPR-efterlevnad och använder aggregerade signaler med samtycke för personakalibrering.
För byråer innehåller det byråanpassade arbetsflödet särskilt teamfunktioner och introduktion av flera kunder.
Checklista för pilot:
- Minsta datamängd: minst 50 historiska experimentutfall med resultat på materialnivå
- Tidsram: två till tre veckor från dataimport till första skarpa adaptiva experimentet
- Framgångskriterier: över 70 % täckning i kandidaturvalet och minst en testarm med statistiskt meningsfullt lyft senast vecka tre
Hur AI införs i teamets dagliga arbete behandlas också väl i denna praktiska guide till AI i marknadsföring från Errant Agency.
Viktigaste slutsatserna
Den mest tillförlitliga vägen till bättre annonsresultat är ett DCO-arbetsflöde i två steg från offline till online: AI-generering styrd av en prognosbaserad rangordningsmodell, följt av adaptiva experiment i omgångar som verifierar vinnare i verklig trafik.
| Punkt | Detaljer |
|---|---|
| Rangordning offline ökar täckningen | Använd den prognosbaserade rangordningsmodellen för att fylla uppsättningen med starka kandidater, inte som en lanseringsregel. |
| Adaptiva experiment verifierar vinnare | Omfördelning i omgångar mot lovande testarmar minskar förlusten jämfört med A/B-testning med jämn fördelning. |
| Syntetiska personor filtrerar bort förlorare i förväg; kalibrerade personor når hög prognosmässig överensstämmelse med paneler av verkliga människor och bör alltid följas av validering i skarpt läge. | |
| Fältlyft gäller de bästa resultaten | Dokumenterade lyft på 36,2 %, 45,1 % och 46,7 % speglar vinsterna för det bästa materialet, inte en genomsnittlig kampanjförbättring. |
| POPJAM integrerar hela arbetsflödet | POPJAMs plattform omfattar generering, personasimulering och testning före lansering på ett ställe. |
Varför det här behöver göras noggrant
Siffrorna från fältexperimenten är verkligen spännande. Lyft bland de bästa resultaten i intervallet 36–47 % är inte marknadsföringstext. De kommer från sakkunniggranskad forskning om arbetsflöden. Men det finns en version av arbetsflödet som team kastar sig in i och nästan inte får något av. Det handlar vanligtvis om ett misstag: att behandla offlinemodellen som ett orakel för lanseringsbeslut.
Rangordningsmodellen är en kompass, inte en GPS. Den begränsar urvalet. Den talar inte om vilket material som vinner på din specifika marknad, med din specifika målgrupp, vid just den tidpunkten i kampanjkalendern. Svaret kommer bara från verkliga data. Team som hoppar över det adaptiva experimentet eftersom rangordningsmodellen ”redan gav svaret” publicerar i princip och hoppas, fast med extra steg.
Det andra jag skulle invända mot är impulsen att bygga en så stor uppsättning som möjligt. Fler kandidater känns som fler möjligheter. I praktiken innebär en uppsättning på tolv med en veckobudget på 3 000 visningar att varje testarm får 250 visningar. Det ger inte alls tillräcklig signal för ett tillförlitligt beslut. En väl avgränsad uppsättning på fyra, körd ordentligt, slår varje gång en spretig uppsättning på tolv när trafiken är begränsad.
Arbetsflödet fungerar. Använd det med disciplin.
POPJAM gör arbetsflödet tillgängligt från dag ett
De flesta team vet att de borde testa mer annonsmaterial. Flaskhalsen är aldrig ambitionen. Den är gapet mellan att ha en bra idé och att ha testat material i linje med varumärket som tryggt kan lanseras.
POPJAM överbryggar det gapet. Du tar med grundmaterial och historiska experimentdata. POPJAM genererar varianter i linje med varumärket, kör dem genom kalibrerade syntetiska personor som ett snabbt förfilter och ger dig en rangordnad uppsättning redo för skarp testning. Hela offlinesteget, som tidigare tog ett kreativt team dagar, körs på timmar.
Plattformen stödjer alla större annonsformat och placeringar på Meta, Google, TikTok, LinkedIn och Reddit. Den är byggd för prestationsmarknadsförare som behöver volym och för byråer med flera kunder som behöver styrning. GDPR-efterlevnad är inbyggd så att träningsdata hålls rena.
Redo att köra din första pilot? Börja med POPJAMs AI-annonsverktyg och ta med dina historiska experimentdata. Inom två till tre veckor kan du ha en rangordnad uppsättning och ett skarpt adaptivt experiment i gång.
Användbara källor
| Källa | Varför den är användbar |
|---|---|
| ArXiv: AI-styrd generering med prognosbaserad rangordningsmodell och adaptiva experiment | Primär forskning om arbetsflödet från offline till online; dokumenterar lyften i de tre fältexperimenten. |
| Neuroflash: fallstudier om syntetiska målgrupper | Dokumenterar ökningar av ROAS, CVR och CTR från syntetiska förtester kombinerade med validering i skarpt läge. |
| InsightIQ: AI-testning av annonsmaterial för e-handel | Praktisk vägledning om testfrekvens, inklusive gallringsregeln 3-3-3 och veckomål för variationer. |
| Omniconvert: AI-generator för annonsmaterial | Ramverk i tre lager för utvärdering av plattformar: produktionshastighet, vinkelns relevans och anpassning till kundlivstidsvärde. |
| POPJAM: plattform för automatisering av annonsmaterial | Produktdokumentation för POPJAMs integrerade arbetsflöde med generering, personasimulering och testning. |
| POPJAM: handbok för generativ AI i marknadsföring | Praktisk implementeringsguide för att koppla generativa modeller till experimentdata och briefar. |
Vanliga frågor
Vad är dynamisk optimering av annonsmaterial i det här sammanhanget?
Här innebär dynamisk optimering av annonsmaterial AI-driven generering före lansering, simulering med syntetiska personor och adaptiva onlineexperiment, inte sammansättning av mallar i realtid på en annonsserver.
Hur mycket historiska data behöver du för att träna en prognosbaserad rangordningsmodell?
Minst 50 randomiserade experimentutfall med resultat på materialnivå är en praktisk utgångspunkt. Mer data ger en mer tillförlitlig rangordningsmodell.
Kan syntetiska personor ersätta skarp A/B-testning?
Nej. Kalibrerade syntetiska personor är ett förfilter som höjer uppsättningens kvalitet, men adaptiva onlineexperiment krävs för att verifiera vinnare under verkliga trafikförhållanden.
Vilka lyft kan du realistiskt förvänta dig av det här arbetsflödet?
Fältexperiment dokumenterade engagemangslyft bland de bästa resultaten på 45,1 %, 46,7 % och 36,2 %. De speglar vinsterna för det bästa materialet, inte en garanterad genomsnittlig kampanjförbättring.
Hur stödjer POPJAM det här arbetsflödet?
POPJAM omfattar AI-generering, simulering med syntetiska personor och testning före lansering i en plattform, med GDPR-enlig datahantering och stöd för Meta, Google, TikTok, LinkedIn och Reddit.
Rekommenderad läsning
- Automatisering av annonsmaterial: den kompletta guiden för prestationsmarknadsförare 2026 | POPJAM.IO-bloggen
- Plattform för automatisering av annonsmaterial | AI-generering och testning av annonser | POPJAM.IO
- Bästa praxis för resultat med prestationsmarknadsföring | POPJAM.IO-bloggen
- Datadrivet annonsmaterial: öka avkastningen med smartare testning | POPJAM.IO-bloggen