Sünteetilised andmed turunduses: praktiline juhend turundajale
Vaata, kuidas sünteetilised andmed võivad sinu kampaaniaid parandada. Kasuta neid tõhusalt sihtrühmade simuleerimiseks ja stsenaariumide testimiseks.
Kasuta sünteetilisi andmeid siis, kui privaatsuspiirangud, valimi suurus või ajakava takistavad tegeliku vastuse saamist. Need sobivad kõige paremini reklaamide eeltestimiseks, sihtrühma simuleerimiseks ja kampaaniastsenaariumide koormustestimiseks ning kõige halvemini täpse isikutasandi tõepärasuse asendamiseks. 4As on dokumenteerinud, kuidas sünteetilised populatsioonid täidavad paneelide ja platvormivalimite jäetud teadmislünki. Privaatsust säilitavat andmeloome protsessi katsetanud teadlased leidsid, et sünteetiliste kampaaniate hinne oli 4,1 viiest, pärisandmetel põhinevatel kampaaniatel 4,2. Erinevus polnud statistiliselt oluline. Forrester nimetas sünteetilised andmed üheks 2025. aasta olulisemaks arenevaks tehnoloogiaks.
Tee nii: ära vii sünteetilisi andmeid kohe laialt tootmiskasutusse. Alusta piloodist.
- Vali üks kitsas kasutusjuht, näiteks reklaami eeltest või üks alaesindatud segment
- Määra otsuste kooskõla lävend enne tulemuste vaatamist
- Võrdle sünteetilistel andmetel põhinevaid otsuseid päris kontrollvalimiga, mitte üksnes sellega, kas andmed „näevad realistlikud välja”.
Statistika: Ühes raamistikus vähendasid optimeeritud sünteetilised populatsioonid soovituste nihet 11,5%-lt 1,2%-le võrreldes tavaliste sünteetiliste mudelitega. See on jätkamise või loobumise otsuste sõelumisel märgatav stabiilsuse paranemine.
Peamised järeldused
Sünteetilised andmed toimivad kõige paremini siis, kui asendavad oletamist privaatsuspiirangute või andmenappusega turundusotsustes ning neid kontrollitakse päris kontrollvalimite vastu enne päris eelarve suunamist.
| Põhimõte | Üksikasjad |
|---|---|
| Alusta otsuste kooskõlast | Kontrolli, kas sünteetilistel andmetel põhinevad otsused kattuvad pärisandmetel tehtud otsustega, mitte üksnes jaotuste sarnasust. |
| Alusta ühest kitsast piloodist | Piiritle reklaami eeltestimine või sihtrühma simulatsioon ning võrdle seda päris kontrollvalimiga enne laiendamist. |
| Jälgi mitmekesisuse kadu | Kontrolli vektorruumi mitmekesisust, et korduvad ja ühetaolised sünteetilised väljundid varakult tabada. |
| Lisa andmehaldus protsessi sisse | Märgista sünteetilised kirjed, versiooni andmestikke ning hoia testkeskkonna andmed tootmisandmetest eraldi. |
| POPJAM sobib eeltestimiseks | POPJAM testib reklaame enne käivitamist sünteetiliste ostjapersoonadega, järgides juhendis soovitatud otsuste kooskõla põhimõtet. |
Sisukord
- Mis on sünteetilised andmed turunduses?
- Millised on sünteetiliste andmete parimad kasutusjuhud turunduses?
- Millal sünteetilisi andmeid kasutada ja millal vältida?
- Kuidas sünteetilisi andmeid luuakse?
- Kuidas kontrollida sünteetiliste andmete sobivust turundusotsusteks?
- Milliseid privaatsus- ja andmehaldusmeetmeid vajad?
- Kuidas sünteetiliste andmete pilooti läbi viia?
- Mida sünteetiliste andmete pakkujatelt küsida?
- Kuidas POPJAM sobitub sünteetiliste andmete turundusstrateegiasse?
- Millised on sünteetiliste andmete piirangud turunduses?
- Kas peaksid järgmises kampaanias sünteetilisi andmeid kasutama?
- Sünteetilised andmed turundaja vaatenurgast
- Allikad
- Korduma kippuvad küsimused
Mis on sünteetilised andmed turunduses?
Sünteetilised andmed on kunstlikult loodud teave, mis jäljendab päris tarbija- või kampaaniaandmete statistilisi mustreid, sisaldamata ühegi tegeliku inimese kirjeid. Need pole võltsandmed juhuslikkuse või väljamõeldise tähenduses. Need on modelleeritud andmed, mis on loodud käituma otsuse jaoks olulistes mõõtmetes nagu pärisandmed.
Turundajad kasutavad mitut eri vormi. Nende segiajamine on kiireim tee meetodi valesti rakendamiseni:
- Struktureeritud tehingu- ja seansilogid: simuleeritud ostuteekonnad, klõpsuvood ja ostulehtri käitumine analüütikaprotsesside testimiseks
- Sünteetilised vastajad või persoonad: psühhograafiliste ja demograafiliste omadustega modelleeritud inimesed, kes asendavad suuremas mahus fookusrühmapaneele
- Pildi- ja videoreklaamide variandid: loodud reklaamimaterjalid sõnumi ning visuaalse suuna testimiseks enne meediakulu
- Sünteetilised päringud: loodud otsingu- või infoleidmispäringud, millega testitakse süsteemi võimet asjakohast sisu leida. Hoolika negatiivsete näidete valikuga parandab see edasist järjestamist
- Relatsioonilised skeemipõhised andmestikud: täielikud sünteetilised andmebaasid, mis säilitavad tabelite seosed ning sobivad taristu testimiseks enne pärisandmete liikumist selles
Sünteetiliste persoonade paneel asendab aeglast ja kallist fookusrühma. Sünteetiline reklaamitagasiside logi võimaldab reklaamivarianti tuhande simuleeritud reaktsiooni vastu proovile panna enne esimese dollari jõudmist Meta reklaamioksjonile.
Millised on sünteetiliste andmete parimad kasutusjuhud turunduses?
Kõik kasutusjuhud ei anna sama palju väärtust. Järjestus näitab, kus sünteetilised andmed turundustiimidele praegu kõige rohkem kasu toovad.
-
Reklaamide eeltestimine. Küsimus: kas reklaamikontseptsioon kõnetab enne käivitamist? Sisendiks on reklaamide kavandid ja sihtsegmentide määratlused. Väljundiks on simuleeritud sihtrühmade prognoositud kaasatus- ja hoiakuskoorid. Hilisem mõõtmine seostub pärast võitja käivitamist tegeliku CTR-i ja konversiooniga. Ühes privaatsusele keskendunud uuringus jäid sünteetilistel andmetel põhinevate kampaaniate asjakohasuse hinded pärisandmete kampaaniatest vaid murdosa punkti kaugusele. See tõendab, et simulatsioon ei pea privaatsuse nimel kvaliteeti ohverdama.
-
Sihtrühma simuleerimine meediaplaneerimiseks. Küsimus: kuidas reageerivad eri segmendid eelarve ümberjaotamisele kanalite vahel? Sisendiks on ajaloolised kulud ja reaktsioonikõverad. Väljundiks on eri stsenaariumide simuleeritud reaktsioonipinnad. Siin on populatsioonitasandi modelleerimine tugev, sest võimaldab planeerijal näha kaugemale juhuslikult kättesaadavast paneelivalimist.
-
Kampaaniastsenaariumide simuleerimine ja koormustestimine. Küsimus: mis läheb katki, kui kampaania satub erandolukorda, näiteks konkurendi järsu hinnalangetuse või platvormireeglite muutuse korral? Suurettevõtete tiimid juba kasutavad sünteetilisi andmeid erandjuhtude ja kontrollitud anomaaliate simuleerimiseks, et leida vead enne tootmiskeskkonda jõudmist. Sama loogika kehtib kampaania vastupidavuse testimisel.
-
Andmete täiendamine külmkäivituse olukorras. Küsimus: kuidas testida sõnumeid täiesti uuele tootele, millel pole ajaloolisi andmeid? Sünteetilised persoonad ja seansilogid annavad esialgse jaotuse, mille vastu testida seni, kuni päris signaali koguneb.
-
Privaatsust säilitav mudelitreening. Küsimus: kas prognoosimudeleid saab treenida reguleeritud isikuandmeid puutumata? Pärisjaotusi jäljendavad sünteetilised andmestikud võimaldavad andmeteaduse tiimidel katsetada ilma iga eksperimendi eraldi vastavuskontrollita.
Praktiline nõuanne: Vali esimene piloot sealt, kus sul on juba võrdluseks päris kontrollvalim. Eeltestimise proovimine varem käivitatud kampaanial annab kontrollaluse esimesel päeval, selle asemel et oodata nädalaid värskeid päristulemusi.
Millal sünteetilisi andmeid kasutada ja millal vältida?
Sünteetilised andmed õigustavad end siis, kui pärisandmed on liiga tundlikud, napid või aeglaselt kogutavad. Meetod ei toimi, kui kasutaja vajab täpset isikutasandi tõde või kui puudub usaldusväärne võrdlusjaotus, mille järgi kalibreerida.
Kasuta neid siis, kui:
- Privaatsuspiirangud piiravad seda, millistele päris tarbijaandmetele saad seaduslikult ligi või mida ühendada
- Sihtsegment on statistiliselt kasuliku pärisvalimi jaoks liiga väike või uus
- Testid varajast kontseptsiooni ega taha kulutada päris sihtrühma head tahet toorele kavandile
- Vajad ründetestimise või erandjuhtude stsenaariume, mida pärisandmetes esineb harva, kuid mis on riskiplaneerimisel tähtsad
Väldi neid või tegutse ettevaatlikult siis, kui:
- Reeglid nõuavad konkreetselt tegelikke ja kontrollitavaid andmeid, näiteks teatud rahanduse või tervishoiuga seotud väidete puhul
- Otsus sõltub populatsioonimustri asemel täpsest individuaalsest käitumisest
- Sünteetilise väljundi kontrollimiseks puudub usaldusväärne pärismaailma võrdlusjaotus
Jätkamise või loobumise kontroll: kui oskad nimetada päris kontrollvalimi, mille vastu tulemusi hindad, ning kasutusjuht ei vaja isikutasandi kindlust, on piloodiks roheline tuli.
Kuidas sünteetilisi andmeid luuakse?
Turundaja ei pea koodi kirjutama, kuid loomismeetodi tundmine kujundab ootusi väljundile.
Generatiivsed võistlevad võrgud ehk GAN-id panevad kaks mudelit vastamisi: üks loob tehisandmeid ja teine püüab neid ära tunda. See jätkub, kuni generaator annab veenvalt realistliku väljundi. GAN-id on tugevad visuaalse ja pildipõhise sünteetilise reklaami loomisel, kuid võivad kannatada mitmekesisuse kao ehk mode collapse’i all. Siis loob mudel tegeliku mitmekesisuse asemel korduvaid variatsioone.
Variatsioonilised autoenkoodrid ehk VAE-d suruvad pärisandmed lihtsustatud esituseks ja rekonstrueerivad sellest uusi näidiseid. Need on GAN-idest stabiilsemad, kuid annavad tavaliselt veidi hägusama ja vähem terava väljundi. See on kliendile nähtava sisu puhul arvestatav kompromiss.
Suurel keelemudelil ehk LLM-il põhinev loomine tekitab juhiste põhjal sünteetilist teksti, persoonasid ja struktureeritud kirjeid. See on paindlik ja kiiresti täiustatav, kuid sõltub tugevalt lähteandmete ning juhiste kvaliteedist.
Skeemipõhised ja mehhanismide kavandamisel põhinevad lähenemised, näiteks Simula andmestike inseneeria raamistik, käsitlevad kogu andmestikku inseneriülesandena, mitte üksiku näidise kaupa loomisena. Nii saab turundaja juhtida kogu andmestiku katvust, keerukust ja kvaliteeti. Tootmiskasutuses on see palju tähtsam kui üksiku kirje realism.
| Hindamiskriteerium | Meetod A: GAN/VAE | Meetod B: LLM-põhine | Meetod C: skeemi- või mehhanismipõhine |
|---|---|---|---|
| Vastavus pärisjaotusele | Piltidel suur, tabelandmetel keskmine | Keskmine, sõltub juhisest | Suur, otseselt juhitav |
| Juhitavus | Väike kuni keskmine | Keskmine | Suur |
| Selgitatavus | Väike | Keskmine | Suur |
| Arvutuskulu | Suur | Keskmine | Keskmine kuni suur |
| Sõltuvus lähteandmetest | Suur | Väga suur | Keskmine |
Kuidas kontrollida sünteetiliste andmete sobivust turundusotsusteks?
Kontrollimise keskne põhimõte on otsuste kooskõla: kas sünteetiline andmestik viib sama äriotsuseni nagu pärisandmestik? Andmestik võib statistiliselt veenev välja näha ja selles testis siiski läbi kukkuda. Praktikud on õppinud, et üksnes marginaaljaotuste sobivusest ei piisa. Sünteetiline populatsioon võib jäljendada tegelikke keskmisi, jättes tabamata nende all oleva otsuse jaoks olulise struktuuri.
Enne sünteetilise andmestiku usaldamist päris eelarveotsuses läbi järgmine nimekiri:
- Kontrollvalimil põhinevad testid. Jaga pärisandmed treening- ja kontrollvalimiks. Loo sünteetilised andmed treeningosast ning kontrolli, kas nende põhjal tehtud otsused kattuvad kontrollvalimi otsustega.
- Mitmekesisuse kao kontrollid. Otsi loodud kirjetest kahtlast korduvust või vähest varieeruvust, mis on GAN-põhiste meetodite tavaline viga.
- Vektorruumi mitmekesisuse mõõdikud. Esita sünteetilised ja päriskirjed samas vektorruumis ning kontrolli, et sünteetiline kogum kataks võrreldava ulatuse, mitte üksnes kitsast klastrit.
- Kihistatud klastrite kontrollid. Jaga populatsioon teadaolevateks alarühmadeks ja kontrolli iga alarühma sünteetilise esituse vastavust päris vastele.
- Inimese pisteline ülevaatus. Koolitatud hindaja vaatab sünteetiliste kirjete valimi üle, otsides struktuurseid vigu ka siis, kui statistilised kontrollid läbiti.
Jälgimist väärt mõõdikud: strateegiasimulatsiooni vastavus ehk kui hästi simuleeritud soovitused järgivad päris soovitusi, uudsete kirjete määr ehk sünteetiliste kirjete osakaal, mis ei korda lihtsalt treeningkogumit, ning vastupanu treeningkogumisse kuulumise tuletamisele ehk kui raske on välja selgitada, kas konkreetse inimese andmeid mudelis kasutati.
Statistika: PolicySynthi raamistikus vähendasid optimeeritud sünteetilised populatsioonid soovituste nihet 11,5 protsendipunktilt 1,2 punktile võrreldes optimeerimata sünteetiliste mudelitega. See toetab tugevalt otsuste kooskõla testimist igas piloodis, mitte üksnes jaotuste sarnasuse usaldamist.
Praktiline nõuanne: *Koosta enne ühegi sünteetilise kirje loomist väike 30–50 pärismaailma tulemusest koosnev „kuldne” hindamiskogum.
Milliseid privaatsus- ja andmehaldusmeetmeid vajad?
Küsi igalt pakkujalt lubaduste asemel tõendeid kolmes valdkonnas: treeningkogumisse kuulumise tuletamise vastased testid, dokumenteeritud uudsete kirjete määr ning selge andmete päritoluahel, mis näitab täpselt, milliste pärisandmetega sünteetilist mudelit treeniti.
Ettevõttesiseselt lisa töövoogu järgmised harjumused:
- Märgista iga sünteetiline kirje metaandmetega, näiteks
source = synthetic, et see ei satuks märkamatult tootmisanalüütikasse - Versiooni sünteetilisi andmestikke nagu koodi, märkides selgelt loomiskuupäeva ja mudeliversiooni
- Piira ligipääsu sünteetiliste andmete loomise protsessidele samamoodi nagu päris kliendiandmetele
- Hoia eraldi testkeskkonda, et sünteetilised ja tootmisandmed ei satuks kogemata samasse tabelisse.
Hoia vastavus- ja õiguspartnerite jaoks valmis lühike materjalipakk: kasutatud loomismeetod, tehtud privaatsustestid, andmete päritolu ja kontrolltulemuste kokkuvõte. Tavaliselt piisab audititiimile sellest piloodi heakskiitmiseks.
Kuidas sünteetiliste andmete pilooti läbi viia?
Piloodil peab olema kindel ulatus, igast funktsioonist nimetatud vastutaja ja lõplik lõppkuupäev. Kaasa andmeinseneeria andmeprotsessi, analüütika valideerimisse, õigustiim privaatsuskontrolli ning inimene, kes vastutab reklaami- või meediaotsuse eest, mida piloot toetama peab.
- Määra üks kitsas äriküsimus, millele piloot peab vastama
- Leia minimaalne pärisandmestik treeningu lähteks ja kontrollvalimiks
- Vali kasutusjuhule sobiv loomismeetod, mitte kõige säravam tehnoloogia
- Sea otsuste kooskõla lävendid enne andmete loomist
- Läbi kontrollnimekiri ja võrdle kontrollvalimiga
- Otsusta laiendamine, täiustamine või lõpetamine varem seatud lävendi, mitte kõhutunde järgi
| Etapp | Tüüpiline kestus | Peamine väljund |
|---|---|---|
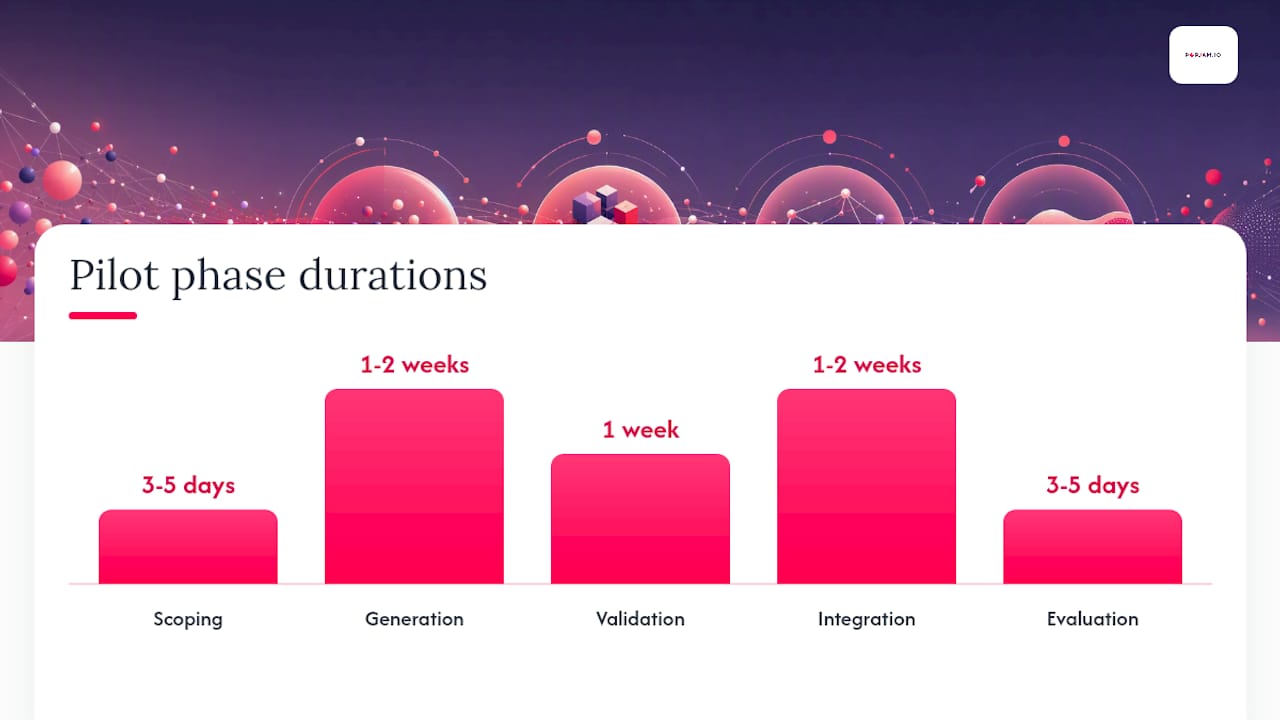
| Ulatuse määramine | 3–5 päeva | Määratletud küsimus, edulävend, nimetatud vastutajad |
| Loomine | 1–2 nädalat | Sünteetilise andmestiku esimene kavand |
| Valideerimine | 1 nädal | Otsuste kooskõla skoor kontrollvalimiga võrreldes |
| Lõimimine | 1–2 nädalat | Andmeprotsessi ühendus olemasolevate analüütikatööriistadega |
| Hindamine | 3–5 päeva | Otsus laiendada, täiustada või lõpetada |
Käsitle edu ulatuse määramisel seatud lävendiga seotud jah-või-ei tulemusena, mitte ebamäärase tundena, et „andmed paistsid head”.
Mida sünteetiliste andmete pakkujatelt küsida?
Pakkujate müügiesitlused on täis enesekindlaid väiteid. Sinu ülesanne on küsida tõendeid, mis peavad kriitilisele kontrollile vastu.
- Kuidas testite vastupanu treeningkogumisse kuulumise tuletamisele ja kas saate tulemusi näidata?
- Milline on uudsete kirjete määr ja kuidas seda mõõdate?
- Kui sageli andmestikku uuendate ja mis käivitab uue loomise?
- Kas saate esitada korratava valideerimisaruande, mitte ainult kokkuvõtliku väite?
- Kuidas väljund meie olemasolevate analüütika- ja reklaamitestimise tööriistadega ühendub?
Hinda pakkujat mõne konkreetse mõõtme järgi, mitte üksnes müügijutu põhjal.
| Mõõde | Mida otsida | Nõrk signaal |
|---|---|---|
| Valideerimine | Korratavad otsuste kooskõla aruanded | Ainult väited „näeb realistlik välja” |
| Läbipaistvus | Loomismeetodi selge dokumentatsioon | Ebamäärane jutt „patenteeritud AI-st” |
| Lõimimine | Toimib olemasoleva analüütikakomplektiga | Nõuab kogu platvormi vahetamist |
| Kulu | Piloodi ulatusega sobiv kasutuspõhine või astmeline hinnastus | Läbipaistmatu ainult suurettevõtetele mõeldud hinnastus |
Nende hindamiskriteeriumide sidumiseks laiema testimisprogrammiga on Kontrol Media kasvuturunduse katsetamise raamistik kasulik lähtekoht, et seada nõutav rangus enne pakkujate hindamist.
Kuidas POPJAM sobitub sünteetiliste andmete turundusstrateegiasse?
POPJAM vastab otseselt eespool toodud suurima väärtusega kasutusjuhtudele. See loob brändile sobivaid reklaame ning testib neid sünteetiliste ostjapersoonadega enne päriskampaaniasse jõudmist. Just sellist reklaamide eeltestimise ja sihtrühma simuleerimise tsüklit turundajad kuluriski vähendamiseks vajavadki.
Piiritletud piloot näeb välja järgmine:
- Laadi üles brändijuhised ja reklaamide kavandite komplekt
- Loo sünteetiliste persoonade reaktsioonid sulle olulistes segmentides
- Vaata enne käivitamist üle psühhograafiline tagasiside ja reklaamiväsimuse signaalid
- Võrdle kõrgeima skooriga variandi päristulemust sünteetilise prognoosiga
Mõõdik: Andmetega toetatud reklaamitestimist kasutavad tiimid teatavad märgatavast tasuvuse kasvust, kui loovotsused põhinevad oletamise asemel sünteetilisel tagasisidel. See muster sobib kogu juhendit läbiva otsuste kooskõla põhimõttega.
Millised on sünteetiliste andmete piirangud turunduses?
Sünteetilised andmed ebaõnnestuvad etteaimataval viisil ning igale probleemile on selge lahendus.
- Lähteandmetele ülesobitumine: sünteetiline kogum kordab treeningandmeid, selle asemel et üldistada. Lahenda see lähteandmete mitmekesisuse suurendamise ja uudsete kirjete kontrollidega.
- Ainult jaotuste sarnasuse usaldamine: andmestik võib statistiliselt õige paista, kuid viia vale otsuseni. Kasuta varem kirjeldatud otsuste kooskõla teste.
- Mitmekesisuse kadu: korduvad ja ühetaolised väljundid on GAN-põhistes meetodites tavalised. Enne väljundi usaldamist kontrolli vektorruumi mitmekesisust.
Sea igale tootmiskasutuses sünteetilisele andmestikule uuendamise sagedus ja ülevaatuse etapp. Tarbijakäitumine muutub hooajati ning eelmise aasta mustritel treenitud sünteetiline mudel aegub märkamatult.
Kas peaksid järgmises kampaanias sünteetilisi andmeid kasutama?
Sünteetilised andmed väärivad kohta turunduse tööriistakomplektis siis, kui kasutus on kitsalt piiritletud, päris kontrollvalimi vastu valideeritud ja käsitletud areneva tööriistana, mitte ühekordse ekspordina. Need ei asenda tegelikku tarbijauuringut. Need vähendavad riski otsustes, mille teeksid muidu sisetunde või liiga väikese valimi põhjal.
Kolm järgmist sammu, mida eelistada:
- Tee sel kvartalil üks kitsas piloot varem seatud otsuste kooskõla lävendiga
- Loo valideerimise kontrollpunkt enne ühegi pakkuja väljundi hindamist
- Vali eespool toodud hindamisraamistiku, mitte kõige säravama demo järgi välja kaks või kolm pakkujat
Alusta POPJAMi piloodist ühe loovotsuse jaoks, mida juba plaanid teha.
Sünteetilised andmed turundaja vaatenurgast
Sünteetiliste andmete tavapärane müügijutt rõhub liiga palju realismile, justkui oleks päris tarbijatega „sarnane” andmestik automaatselt kasulik. Ei ole. Otsuste kooskõla uuringud toovad välja täpsema mõtte: sünteetiline populatsioon võib tabada kõiki marginaaljaotusi ja ikkagi suunata sind vale reklaami või eelarvejaotuse juurde, sest tegelikke otsuseid kujundav struktuur on koondstatistikast peenem.
Alahinnatakse selle tehnoloogia piloodina katsetamise lihtsust. Turundaja ei vaja andmeteaduse tiimi, et sel kuul üht reklaamikontseptsiooni sünteetiliste persoonadega testida. Ta vajab kitsast küsimust, päris kontrollvalimit ja distsipliini seada lävend enne tulemuste vaatamist. Enamik tiime jätab viimase osa vahele ning hakkab hiljem põhjendama ükskõik millist saadud arvu.
Siin vaidleksin tavapärasele nõuandele vastu: ära otsi esmalt tehniliselt kõige keerukamat loomismeetodit. Alusta valideerimisdistsipliinist. Korralikult kontrollitud skeemipõhine andmestik on parem kui uhke LLM-i loodud kogum, mida keegi pole tegelikkusega võrrelnud.
Allikad
- Usaldusväärsed sünteetilised andmed kampaaniaotsuste toetamiseks: strateegiasimulatsiooni vastavus ja PolicySynthi raamistik
- Ettevõtte sünteetiliste andmete strateegia loomine Amazon Bedrockiga
- Lünkade täitmine: kuidas sünteetilised andmed muudavad turundusmaastikku
- Privaatsuse säilitamine turunduses: sünteetiliste andmete võrdlev uuring personaliseeritud kampaaniate loomiseks
- Sünteetiliste andmestike kujundamine pärismaailmale: mehhanismide kavandamine ja algpõhimõtetest lähtuv arutlus
- Miks sünteetilised andmed võivad olla reklaaminduse järgmine suur panus
Korduma kippuvad küsimused
Mida tähendab „sünteetilised andmed”?
Sünteetilised andmed on kunstlikult loodud teave, mis jäljendab pärisandmete statistilisi mustreid, näiteks tarbijakäitumist või kampaaniareaktsioone, sisaldamata ühegi tegeliku inimese kirjeid.
Millised on turunduses kasutatavate sünteetiliste andmete näited?
Näited on sünteetilised ostjapersoonad sihtrühma simuleerimiseks, sünteetilised reklaamitagasiside logid reklaamide testimiseks, sünteetilised tehingulogid andmeprotsesside testimiseks ning sünteetilised päringud infoleidmise ja otsingu testimiseks.
Kuidas sünteetilisi andmeid luua?
Levinud meetodid on generatiivsed võistlevad võrgud ja variatsioonilised autoenkoodrid pildi- ning tabelandmete jaoks, suured keelemudelid teksti ja persoonade loomiseks ning skeemipõhised mehhanismide kavandamise meetodid täielike tootmisandmestike jaoks. Igaühel on omad kompromissid vastavuses, juhitavuses ja kulus.
Kas ChatGPT on treenitud sünteetilistel andmetel?
Suured keelemudelid, sealhulgas ChatGPT, on kasutanud sünteetilisi andmeid laiema treeninguprotsessi osana, eriti sünteetiliste päringute ja struktureeritud teksti loomise ülesannetes. Ühegi konkreetse mudeliversiooni täpset treeningkoosseisu ei ole siiski täielikult avalikustatud.
Kuidas teada, kas sünteetilised andmed on turundusotsuse jaoks usaldusväärsed?
Kontrolli esmalt otsuste kooskõla: tee kontrollvalimiga test, et näha, kas sünteetilistel andmetel põhinevad otsused kattuvad pärisandmete otsustega. Enne väljundi usaldamist eelarveotsustes kinnita tulemused mitmekesisuse kao ja mitmekesisuse kontrollidega.
Soovitatud
- Mis on andmetega toetatud turundus? Saavuta suurem tasuvus | POPJAM.IO blogi
- Andmetega toetatud reklaamid: suurenda kampaania tasuvust 47% | POPJAM.IO blogi
- Generatiivne AI turunduses: sinu 2026. aasta tegevusjuhend | POPJAM.IO blogi
- Mis on sünteetilised persoonad? AI-persoonad turunduseks | POPJAM | POPJAM.IO blogi